Quanto custa criar uma IA generativa do zero?
 Rael Rodrigues
Todo mundo já brincou com o ChatGPT, o Gemini ou algum outro assistente de IA e, em algum momento, se perguntou: quanto custou construir isso? A resposta curta é “muito”. A resposta longa é bem mais interessante, porque envolve décadas de tentativa e erro, invernos de financiamento, uma virada tecnológica em 2017 e, hoje, orçamentos que rivalizam com o de pequenos países.
Para entender por que uma IA generativa custa o que custa, primeiro precisamos voltar bem antes do GPT-3 — porque a conta que se paga hoje é resultado de quase sete décadas de pesquisa acumulada.
Uma linha do tempo até chegar às LLM’s
A ideia de uma máquina que aprende sozinha não nasceu com o ChatGPT. Ela começou em 1957, quando o pesquisador Frank Rosenblatt criou o perceptron, a primeira tentativa bem-sucedida de fazer uma máquina aprender com exemplos, sem que alguém precisasse programar manualmente cada regra. Era um neurônio artificial solitário, capaz de tomar decisões binárias simples.
O entusiasmo durou pouco. Em 1969, Marvin Minsky e Seymour Papert provaram matematicamente que o perceptron sozinho não conseguia resolver problemas não lineares básicos, e isso, somado à escassez de poder computacional da época, jogou a área inteira num período de descrédito e cortes de verba que ficou conhecido como o “Inverno da IA”.
A virada começou em 1982, John Hopfield mostrou que redes com retroalimentação podiam armazenar memórias, reacendendo o interesse acadêmico. Quatro anos depois, em 1986, David Rumelhart popularizou o backpropagation, o algoritmo que permite ajustar os pesos de redes com várias camadas — a base de praticamente tudo que viria depois, ainda que o treinamento continuasse extremamente lento para os padrões da época.
Nos anos seguintes vieram as peças que faltavam: as redes convolucionais (CNNs), pensadas para reconhecer imagens, e, em 1997, as LSTMs, criadas por Sepp Hochreiter e Jürgen Schmidhuber para resolver o problema do “desvanecimento do gradiente” e finalmente permitir que redes neurais processassem sequências longas — frases, por exemplo. Foi essa arquitetura, aliás, que o Google usou em 2015 para reconhecimento de voz e o Facebook usou em 2017 para tradução automática.
O verdadeiro divisor de águas, porém, veio de outro lugar: em 2012, a AlexNet venceu a competição ImageNet e reduziu a taxa de erro em reconhecimento de imagens de 26% para 15%, provando que redes profundas, alimentadas por GPUs e grandes volumes de dados, superavam qualquer coisa vista até então. Estava dado o pontapé da “Primavera da IA”.
E então, em 2017, oito pesquisadores do Google acreditavam que existia uma maneira mais eficiente de ensinar computadores a compreender linguagem. O resultado daquele trabalho foi um artigo científico de apenas oito páginas chamado Attention Is All You Need , apresentando a arquitetura Transformer — a peça que faltava para escalar modelos de linguagem a um tamanho nunca antes imaginado. Foi a partir dela que nasceram o GPT, o BERT e, poucos anos depois, todas as LLMs que conhecemos hoje como o Gemini, Claude e Llama.
O custo da primeira grande LLM: O caso do GPT-3
Depois do Transformer, vieram vários modelos importantes. O BERT, lançado pelo Google em 2018, revolucionou tarefas de compreensão de linguagem. Em 2019, a OpenAI apresentou o GPT-2, que já era capaz de produzir textos surpreendentemente coerentes. Mas foi apenas em 2020 que a empresa lançou o GPT-3, um modelo tão grande que mudou definitivamente a percepção do mercado sobre o potencial das LLMs.
Se o Transformer deu o mapa, o GPT-3, com 175 bilhões de parâmetros, foi quem mostrou o preço da viagem.
Para efeito de comparação, o GPT-2 possuía cerca de 1,5 bilhão de parâmetros. O GPT-3 saltou para 175 bilhões — aproximadamente 117 vezes mais. Essa mudança mostrou que aumentar a escala dos modelos produzia ganhos de capacidade muito maiores do que muitos pesquisadores imaginavam.
Um modelo desse tamanho simplesmente não cabe em uma única GPU. É preciso distribuir o treinamento por um cluster inteiro de máquinas trabalhando em paralelo — o que, por si só, já encarece o treinamento final entre 1,5 e 5 vezes em relação a uma estimativa ideal de hardware. Só para colocar o modelo pronto para funcionar (sem contar o treino), estimava-se a necessidade de pelo menos 11 GPUs Tesla V100 de 32 GB, a US$ 9 mil cada — cerca de US$ 99 mil apenas no cluster, fora RAM, CPUs, SSDs e fontes de energia.
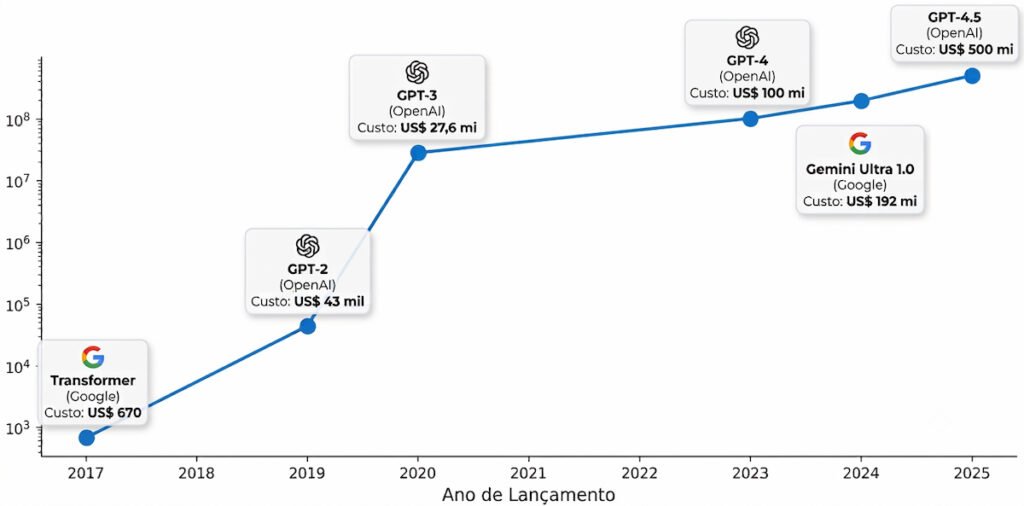
E o treinamento em si? A Lambda Labs calculou que replicar o GPT-3 do zero, usando a nuvem de GPU mais barata disponível na época, levaria 355 anos em uma única GPU e custaria cerca de US$ 4,6 milhões — daí a necessidade de espalhar essa carga por milhares de GPUs simultâneas, comprimindo o tempo real para algumas semanas. Quando se soma tudo — experimentos, ajustes, infraestrutura e pesquisa —, o projeto completo do GPT-3 é estimado entre US$ 11,5 milhões e US$ 27,6 milhões, fora os salários da equipe.
Como os custos explodiram depois disso
Se o GPT-3 já parecia um projeto de outro planeta em 2020, o que veio depois faz aquele valor parecer modesto.
O GPT-4, lançado em 2023, teria custado somente em poder computacional entre US$ 78 milhões e mais de US$ 100 milhões, segundo o Stanford AI Index Report 2025 — número que o próprio CEO da OpenAI, Sam Altman, confirmou publicamente ao dizer que o treinamento passou dos US$ 100 milhões. O Gemini Ultra 1.0, do Google, foi ainda mais longe: cerca de US$ 192 milhões. O Llama 3.1 405B, da Meta, ficou na casa dos US$ 170 milhões.
Para dar a real dimensão desse salto: o primeiro modelo Transformer, em 2017, custava apenas US$ 670 para ser treinado — uma alta de aproximadamente 287.000 vezes até chegarmos ao GPT-4.
Por que ficou tão caro?
O aumento dos custos não aconteceu por um único motivo. Na verdade, quatro fatores evoluíram ao mesmo tempo e passaram a se multiplicar entre si.
- Escala de dados e parâmetros. Cada nova geração de modelo é treinada com mais dados e mais parâmetros que a anterior. Mais parâmetros exigem mais memória de GPU, mais operações matemáticas e, consequentemente, mais tempo de máquina.
- Hardware de ponta escasso. GPUs como as Nvidia H100 são produzidas em quantidade limitada, têm alta demanda global e custam dezenas de milhares de dólares cada — e um treinamento de ponta usa milhares delas simultaneamente, por semanas ou meses seguidos.
- Energia e infraestrutura. Milhares de GPUs rodando ininterruptamente consomem uma quantidade de eletricidade comparável à de uma cidade pequena, além de exigirem sistemas de refrigeração robustos para não superaquecer.
- Capital humano. Por trás de cada modelo existe um time de pesquisadores extremamente especializados e caros — muitas vezes esse é o item mais subestimado do orçamento total.
Some tudo isso e entenda por que, segundo o mesmo relatório de Stanford, treinar um modelo de fronteira hoje é considerado um investimento que ultrapassa os US$ 100 milhões só em computação.
Como se treina uma LLM hoje, na prática
Falamos até aqui de valores totais, mas vale abrir a caixa-preta: o que exatamente se compra com esses milhões? O processo moderno de criar uma LLM acontece, essencialmente, em duas grandes fases.
A primeira é o pré-treinamento, a etapa mais cara e demorada de todas. É nela que o modelo “lê” trilhões de tokens de texto — livros, sites, código, artigos — e aprende, por tentativa e erro, a prever a próxima palavra de uma frase. É um processo bruto, de força computacional pura, que pode levar semanas ou meses rodando ininterruptamente em milhares de GPUs. Ao final dessa fase, o modelo já “sabe” muita coisa sobre o mundo, mas ainda não sabe conversar — ele apenas completa textos.
Para ter uma ideia da escala, trilhões de tokens correspondem a um volume de texto equivalente a milhões de livros, bilhões de páginas da internet, repositórios completos de código-fonte e artigos científicos em dezenas de idiomas.
É aí que entra a segunda fase, o pós-treinamento, dividida em blocos menores e bem mais baratos:
- SFT (Supervised Fine-Tuning): o modelo é ajustado com um conjunto relativamente pequeno de exemplos de alta qualidade — algo entre 5 mil e 50 mil pares de pergunta e resposta cuidadosamente selecionados — que ensinam o formato de resposta esperado e como seguir instruções. É bem menos dado do que o pré-treinamento, mas exige exemplos muito mais refinados.
- Alinhamento por feedback humano (RLHF): nessa etapa, pessoas avaliam pares de respostas do modelo e indicam qual preferem. Esses julgamentos treinam um “modelo de recompensa”, que por sua vez é usado para ajustar o modelo principal via aprendizado por reforço, tornando as respostas mais úteis, seguras e alinhadas ao que humanos realmente esperam.
- Variações mais recentes: em 2026, boa parte dos laboratórios já substituiu o RLHF tradicional por técnicas mais leves, como DPO (Direct Preference Optimization) e RLAIF (feedback gerado por outras IAs em vez de humanos), que entregam resultados parecidos com bem menos custo e complexidade operacional.
Depois de tudo pronto, ainda existe uma etapa contínua de avaliação — rodar o modelo contra baterias de testes de segurança, precisão e viés — antes de qualquer lançamento público.
Quando o objetivo não é criar uma LLM do zero, mas adaptar um modelo já pronto para uma tarefa específica, esse pós-treinamento pode ser feito com técnicas bem mais leves, como o LoRA e o QLoRA, que ajustam apenas uma fração dos parâmetros do modelo original. Isso muda completamente a equação de hardware: enquanto o fine-tuning completo de um modelo de 70 bilhões de parâmetros exige algo como 1.2 TB de memória de GPU, o mesmo ajuste com QLoRA em um modelo de 7 bilhões pode rodar com apenas 4 GB de VRAM — viável até em uma boa placa de vídeo de consumidor.
Treinar não é a mesma coisa que usar
O valor gigantesco de que falamos até aqui é o custo de treinar o modelo — o processo único (ou repetido a cada nova versão) de ensiná-lo do zero. Depois de pronto, usar o modelo no dia a dia — o que chamamos de inferência — é uma conta completamente diferente, e recorrente.
Estima-se, por exemplo, que manter o ChatGPT rodando para milhões de usuários custe algo em torno de US$ 100 mil por dia, ou cerca de US$ 3 milhões por mês — e isso considerando apenas os servidores respondendo às perguntas, sem contar o treino original. É esse o motivo pelo qual empresas de IA cobram por token nas suas APIs: cada resposta gerada consome eletricidade e tempo de GPU, mesmo que o modelo já esteja pronto há meses.
Por isso, embora o treinamento seja o gasto mais chamativo, o custo de inferência, somado ao longo do tempo e multiplicado por milhões de usuários simultâneos, também pesa — e pesa bastante — no orçamento de qualquer empresa que opera uma IA generativa em produção.
Curiosidades sobre os custos
- O primeiro Transformer, em 2017, custava US$ 670. O GPT-4 custou cerca de 287 mil vezes mais — um crescimento que nenhuma outra tecnologia de consumo teve em tão pouco tempo.
- Estima-se que o custo de computação em treinamento de IA dobra a cada cinco meses, um ritmo ainda mais acelerado que a clássica Lei de Moore dos semicondutores.
- Quando a chinesa DeepSeek anunciou, em 2025, que havia treinado seu modelo V3 por apenas US$ 5,6 milhões, o anúncio foi suficiente para derrubar cerca de US$ 1 trilhão em valor de mercado das big techs de tecnologia dos EUA e da Europa em um único dia. Depois, análises mais aprofundadas mostraram que esse valor considerava apenas a rodada final de treinamento, não o custo total do projeto — mas o episódio ainda assim expôs como a eficiência pode abalar um mercado inteiro.
- A diferença de escala entre laboratórios é gritante: enquanto a OpenAI opera com cerca de 100 mil GPUs, a DeepSeek trabalhou com apenas 2 mil unidades NVidia H800 — uma fração do hardware, para resultados competitivos.
Como empresas menores conseguem competir?
Diante desses números, é natural pensar que só gigantes como Google, OpenAI e Meta podem brincar nesse jogo. Mas a realidade é mais democrática do que parece, por alguns motivos:
Reaproveitar em vez de começar do zero. Em vez de treinar uma LLM inteira, a maioria das empresas parte de um modelo open source já pronto — como Llama, Mistral ou DeepSeek — e faz apenas um ajuste fino (fine-tuning) para uma tarefa específica. Isso reduz o investimento de dezenas de milhões de dólares para, muitas vezes, poucos milhares em créditos de nuvem.
Modelos menores e mais eficientes. Nem toda aplicação precisa de um modelo com centenas de bilhões de parâmetros. Modelos entre 7 e 70 bilhões de parâmetros podem ser treinados por valores entre US$ 50 mil e US$ 6 milhões, uma fração do custo de um modelo de fronteira, e ainda assim atendem bem a boa parte das aplicações comerciais.
Inovação em arquitetura, não só em força bruta. O caso da DeepSeek é o exemplo mais claro disso: a empresa usou uma técnica chamada Multi-Head Latent Attention, que reduziu os custos de inferência em 93,3% ao economizar memória de cache, além de uma abordagem de aprendizado por reforço que diminuiu a dependência de treinamento supervisionado tradicional. O resultado foi um modelo competitivo treinado com uma fração do hardware dos concorrentes ocidentais.
Foco em nicho em vez de generalidade. Empresas menores frequentemente abrem mão de competir num modelo “faz tudo” e escolhem resolver bem um problema específico — atendimento ao cliente, geração de código, análise jurídica — o que exige muito menos dados e parâmetros do que um assistente genérico.
SLM: quando “pequeno” é a decisão mais inteligente
Nem toda empresa precisa de um modelo do tamanho do GPT-4. É aí que entram os SLMs, os Small Language Models: modelos de linguagem com contagem de parâmetros geralmente entre alguns milhões e cerca de 7 bilhões, projetados para rodar em hardware limitado, de servidores modestos a dispositivos locais, como celulares e computadores comuns.
A diferença para uma LLM não é só de tamanho, é de filosofia. Enquanto uma LLM gigante tenta responder qualquer pergunta do planeta, um SLM jurídico, por exemplo, sabe tudo sobre contratos e nada sobre receitas de bolo — e é exatamente essa especialização que boa parte das aplicações reais precisa.
Como um SLM chega a ser tão menor e ainda assim útil? Duas técnicas fazem a diferença. A primeira é a destilação de conhecimento, em que um modelo “aluno” pequeno é treinado para imitar as respostas de um modelo “professor” muito maior — foi assim que a série Phi-3, da Microsoft, manteve mais de 90% da capacidade do modelo original usando apenas 5% do tamanho. A segunda é a qualidade em vez da quantidade de dados: em vez de trilhões de tokens genéricos da internet, um SLM é treinado com conjuntos de dados curados e de altíssima qualidade, muitas vezes sintéticos e revisados a dedo.
O ganho prático é enorme. Comparado a uma LLM de fronteira, um SLM especializado pode custar até 180 vezes menos para operar, responder com 16 vezes menos latência (cerca de 50ms contra 800ms) e sustentar um volume de respostas muito maior por segundo. Em cenários de altíssimo volume — atendimento ao cliente, triagem de tickets, extração de dados de documentos —, essa diferença de custo e velocidade não é só uma economia, é o que define se o produto é viável ou não.
Isso não significa que SLMs substituem LLMs — significa que, cada vez mais, as duas coisas convivem. Uma estratégia comum hoje é o modelo híbrido: usar um SLM para resolver a maior parte das perguntas simples e repetitivas, e só escalar para uma LLM de fronteira quando o problema exige raciocínio mais complexo — um padrão de “roteador” que combina o melhor dos dois mundos. Outra estratégia comum entre empresas é começar prototipando com uma LLM genérica, entender bem o problema e, só depois, migrar a aplicação final para um SLM ajustado especificamente para aquele caso de uso, reduzindo drasticamente o custo operacional em produção.
Conclusão
A conta de criar uma IA generativa de ponta saiu de centenas de dólares, em 2017, para centenas de milhões, hoje — um crescimento vertiginoso puxado por mais dados, mais parâmetros, hardware caríssimo e disputado, e times de pesquisa que custam uma fortuna. Mas o mesmo mercado que criou essa barreira também vem criando as ferramentas para contorná-la: modelos abertos, técnicas de ajuste fino e inovações de arquitetura como as da DeepSeek mostram que eficiência, às vezes, vale mais do que força bruta. O resultado é um cenário paradoxal, mas real: nunca foi tão caro treinar uma IA do zero — e, ao mesmo tempo, nunca foi tão barato construir uma aplicação de IA generativa de qualidade em cima do trabalho de quem já pagou essa conta.
Se a história da computação serve de referência, é possível que os custos para criar modelos de fronteira continuem aumentando, enquanto o custo para utilizar inteligência artificial continue caindo. Foi assim com computadores, armazenamento, internet e computação em nuvem. A IA parece seguir exatamente o mesmo caminho.
Comentários (0)
Seja o primeiro a comentar.