Pandas vs Polars: um guia comparativo para manipulação de dados em Python
 Rael Rodrigues
Pandas e Polars estão entre as principais ferramentas do ecossistema Python para trabalhar com dados tabulares, mas seguem abordagens diferentes para executar e otimizar operações. Neste artigo, vamos conhecer as características de cada biblioteca, entender suas principais diferenças e analisar, na prática, como essas escolhas podem impactar desempenho, memória e processamento de grandes volumes de dados.
Um breve histórico do Pandas
O desenvolvimento do Pandas começou em 2008, criado por Wes McKinney enquanto trabalhava na AQR Capital Management, uma gestora de fundos quantitativos. A necessidade era simples de descrever e difícil de resolver: analisar dados financeiros tabulares em Python com a mesma produtividade que ferramentas como R já ofereciam na época. Em 2009 o projeto foi liberado como código aberto, e nos anos seguintes se tornou a espinha dorsal do ecossistema de dados em Python.
Hoje o Pandas é praticamente sinônimo de “análise de dados em Python”. Ele introduziu as estruturas Series e DataFrame, que se tornaram o vocabulário padrão para quem trabalha com dados tabulares na linguagem, e influenciou diretamente bibliotecas em outras linguagens e até em outros frameworks Python.
O que o Pandas faz
Na prática, o Pandas se tornou a ferramenta padrão para ler e escrever dados nos mais diversos formatos, como CSV, Excel, Parquet, SQL e JSON, e depois trabalhar em cima desses dados: limpando, filtrando, transformando e agrupando informações. Ele também facilita a combinação de tabelas por meio de operações como merge, join e concat, oferece um suporte robusto para séries temporais e se integra naturalmente com bibliotecas de visualização e machine learning, como Matplotlib e Scikit-learn. É justamente essa combinação de flexibilidade e integração com o resto do ecossistema Python que explica sua popularidade ao longo de tantos anos.
As limitações do Pandas
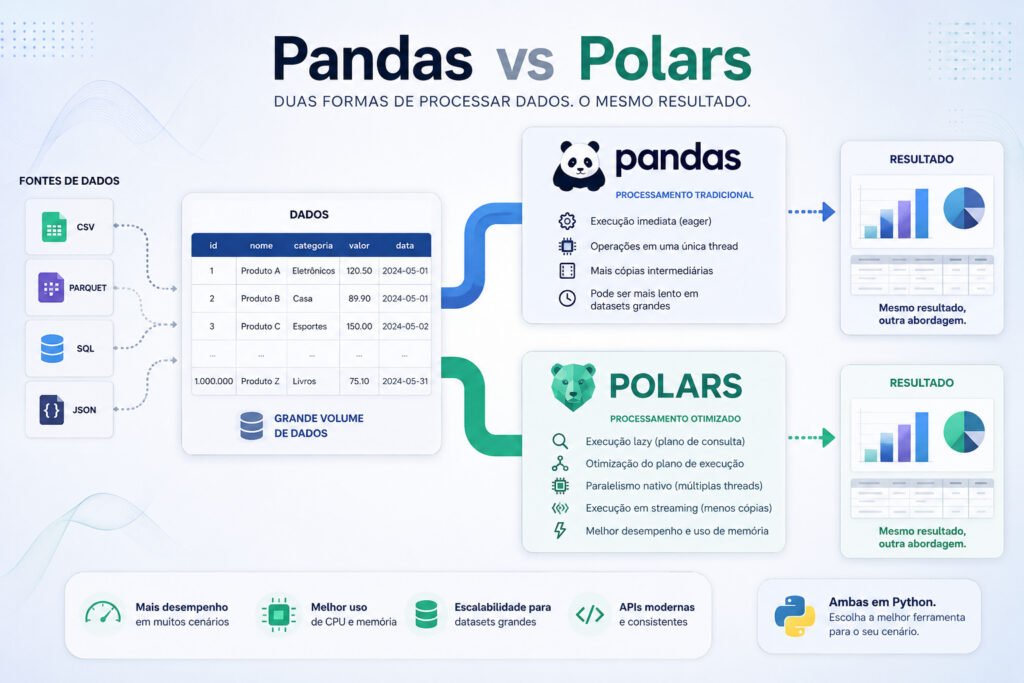
Apesar de sua enorme utilidade, o Pandas carrega limitações que se tornam mais evidentes conforme o volume de dados cresce. A primeira delas é o desempenho em datasets grandes: O Pandas foi projetado originalmente para análise de dados tabulares em memória e não tinha como objetivo principal explorar paralelismo em múltiplos núcleos para grandes volumes de dados. Relacionado a isso está o uso de memória: O consumo de memória pode aumentar significativamente durante determinadas operações, especialmente quando são criadas cópias intermediárias dos dados.
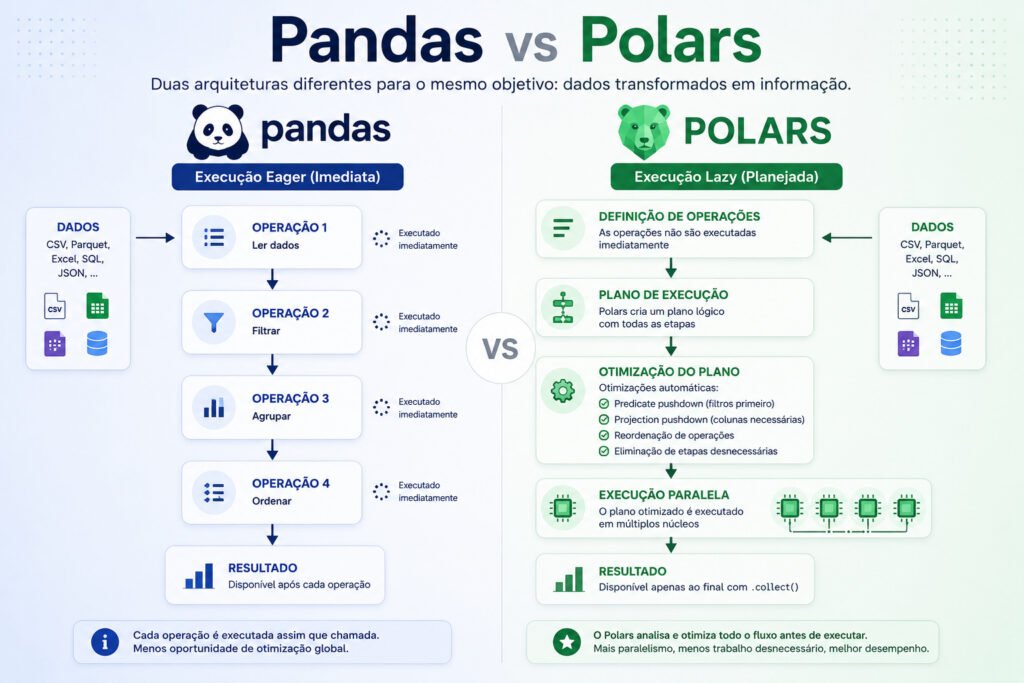
Outro ponto sensível é que, por padrão, grande parte das operações do Pandas roda em uma única thread, não aproveitando automaticamente os múltiplos núcleos de CPU disponíveis na máquina. Some-se a isso o fato de que, por ter crescido organicamente ao longo de mais de uma década, o Pandas acumulou múltiplas formas de fazer a mesma coisa e comportamentos que variam entre índices e colunas. Por fim, o Pandas executa cada operação imediatamente (o chamado modo “eager“), sem a chance de otimizar uma cadeia inteira de transformações antes de efetivamente rodá-la.
Alternativas ao Pandas
Essas limitações abriram espaço para uma nova geração de ferramentas que tentam resolver os mesmos problemas com arquiteturas mais modernas, cada uma com uma proposta diferente: o Dask paraleliza o Pandas em múltiplos núcleos ou até em clusters mantendo uma API parecida, o Vaex é voltado a datasets que não cabem na memória, o Modin promete acelerar o Pandas trocando apenas a linha de import
, o cuDF processa dados usando GPU, e o DuckDB funciona como um banco analítico embarcado para rodar SQL diretamente sobre arquivos como Parquet e CSV. Neste artigo, vamos focar no Polars, uma biblioteca escrita em Rust que se tornou uma das alternativas mais populares e é hoje um dos principais concorrentes diretos do Pandas.
O histórico do Polars
O Polars foi criado por Ritchie Vink, um engenheiro holandês, e teve sua primeira versão pública lançada em 2020. Diferente do Pandas, que nasceu em Python, o Polars foi escrito em Rust, uma linguagem de sistemas conhecida por combinar alta performance com segurança de memória.
A motivação de Vink era clara: construir um DataFrame que aproveitasse ao máximo o hardware moderno — múltiplos núcleos de CPU, uso eficiente de memória e vetorização — sem herdar as limitações de design do Pandas. O projeto cresceu rapidamente na comunidade justamente por entregar ganhos de performance expressivos com uma API que, ainda assim, resulta familiar para quem já usa Pandas.
Hoje o Polars é mantido por uma comunidade ativa e por uma empresa (Polars Inc.), e continua evoluindo com foco em performance e em uma experiência de usuário consistente.
O que o Polars faz
Assim como o Pandas, o Polars permite ler e escrever dados em formatos como CSV, Parquet, JSON e Excel, além de se conectar a bancos de dados. A partir daí, ele oferece as mesmas operações essenciais de qualquer ferramenta de manipulação de dados tabulares: filtrar, transformar e agregar informações, fazer joins, agrupamentos com group_by e operações de janela (window functions), além de trabalhar bem com séries temporais. A diferença não está tanto no “o quê”, que é bastante parecido com o Pandas, mas no “como” — a arquitetura por baixo dos panos é bem diferente, e é isso que explica os ganhos de performance.
Um conceito central para entender o Polars é a existência de duas estruturas principais: o DataFrame e o LazyFrame. O DataFrame funciona de forma parecida com o que já se conhece do Pandas: as operações são executadas imediatamente (modo eager), e o resultado fica disponível na hora, o que é ótimo para explorar dados de forma interativa, como em um notebook. Já o LazyFrame representa apenas um plano de operações ainda não executado — ao encadear filter, select, group_by e outras transformações sobre um LazyFrame, o Polars não processa nada de imediato, apenas registra as etapas. Só quando o método .collect() é chamado é que o motor de query analisa todo esse plano, aplica otimizações (como eliminar colunas não utilizadas ou empurrar filtros para o mais cedo possível) e executa tudo de forma paralela. Na prática, qualquer DataFrame pode virar um LazyFrame (com .lazy()) e vice-versa, o que dá flexibilidade para escolher entre explorar dados rapidamente ou otimizar um pipeline de processamento mais pesado.
Por que o Polars é usado
O principal motivo por trás da popularidade do Polars é a performance: por ser escrito em Rust e usar a biblioteca Apache Arrow como formato de memória colunar, ele costuma ser significativamente mais rápido que o Pandas, principalmente em datasets grandes. Parte desse ganho vem do paralelismo nativo — o Polars distribui automaticamente o trabalho entre os núcleos disponíveis da CPU, sem que o usuário precise configurar nada manualmente.
Outro diferencial importante é o modo lazy, ou execução preguiçosa: o Polars permite construir uma cadeia inteira de operações sem executá-la imediatamente. Ele analisa todo o plano de execução e aplica otimizações automáticas, como eliminar colunas que não serão usadas ou reordenar filtros, antes de efetivamente rodar tudo. Isso, combinado com o formato de memória Arrow, também torna o uso de memória mais eficiente, já que o Polars evita cópias desnecessárias de dados durante as operações. Por fim, como foi desenhado do zero e não carrega o peso de compatibilidade retroativa que o Pandas acumulou ao longo dos anos, o Polars tende a ter uma API mais consistente e previsível.
Principais diferenças entre Pandas e Polars
| Aspecto | Pandas | Polars |
| Linguagem de implementação | Python/Cython/C | Rust |
| Execução | Eager (imediata) | Eager e Lazy (à escolha) |
| Execução lazy | Não possui nativamente | Sim, via LazyFrame e .collect(), com otimização automática do plano de execução |
| Paralelismo | Limitado, majoritariamente single-thread | Multi-thread nativo |
| Performance | Boa para datasets pequenos e médios; degrada em volumes grandes | Geralmente mais rápida, principalmente em datasets grandes |
| Datasets grandes | Pode sofrer com lentidão e estouro de memória | Tende a lidar melhor, especialmente com execução lazy/streaming e paralelismo |
| Formato de memória | Estruturas baseadas principalmente em NumPy, com suporte crescente a Arrow | Apache Arrow / Representação colunar |
| Índice (index) | Possui um índice explícito | Não possui índice; usa apenas colunas |
| Suporte a GPU | Não possui execução nativa em GPU | Suporte a GPU ainda limitado; o foco principal é CPU |
| Uso de SQL | Não possui um mecanismo SQL nativo; pode utilizar bibliotecas e ferramentas externas | Possui suporte a SQL por meio do SQLContext |
| Ecossistema | Muito maduro, mais de 15 anos, integrado a quase todas as libs de dados | Mais recente, em crescimento acelerado, mas ainda menor |
| Curva de aprendizado | Familiar para quem já usa Excel/planilhas; Ampla documentação e grande quantidade de exemplos | Curva inicial um pouco mais íngreme por causa das expressions e dos modos eager/lazy, mas API mais consistente |
| Compatibilidade com outras bibliotecas | Suporte nativo amplo (Scikit-learn, Matplotlib, Seaborn, Statsmodels etc.) | Suporte crescente, muitas vezes via conversão para Pandas/NumPy/Arrow |
| Uso de memória | Tende a copiar mais dados | Mais eficiente, menos cópias |
Uma diferença conceitual importante é que o Pandas usa um índice como identidade de cada linha, enquanto o Polars simplesmente não tem esse conceito — cada linha é identificada apenas pela sua posição.
Exemplos de código: Pandas vs Polars
Instalação
# instalando o pandas
pip install pandas

# instalando o polars
pip install polars
Lendo um CSV
# pandas
import pandas as pd
df = pd.read_csv("vendas.csv")

# polars
import polars as pl
df = pl.read_csv("vendas.csv")
Filtrando e selecionando colunas
# pandas
resultado = df[df["valor"] > 100][["cliente", "valor"]]

# polars
resultado = df.filter(pl.col("valor") > 100).select(["cliente", "valor"])
Criando uma nova coluna
# pandas
df["valor_com_imposto"] = df["valor"] * 1.1

# polars
df = df.with_columns(
       (pl.col("valor") * 1.1).alias("valor_com_imposto")
)
Agrupando e agregando dados
# pandas
resumo = df.groupby("categoria").agg(
           total_vendas=("valor", "sum"),
           media_vendas=("valor", "mean")
).reset_index()

# polars
resumo = df.group_by("categoria").agg([
           pl.col("valor").sum().alias("total_vendas"),
           pl.col("valor").mean().alias("media_vendas")
])
Juntando duas tabelas (join)
# pandas
df_final = pd.merge(pedidos, clientes, on="cliente_id", how="left")

# polars
df_final = pedidos.join(clientes, on="cliente_id", how="left")
Usando execução lazy no Polars
Um dos grandes diferenciais do Polars é o modo lazy, que não tem equivalente direto e nativo no Pandas:
# polars
resultado = (
        pl.scan_csv("vendas.csv")           # não lê o arquivo ainda
        .filter(pl.col("valor") > 100)
        .group_by("categoria")
        .agg(pl.col("valor").sum().alias("total"))
        .sort("total", descending=True)
        .collect()                          # só aqui o plano é executado
)
Nesse modo, o Polars monta um plano de execução, aplica otimizações automáticas (como filtrar antes de agregar e ler somente as colunas necessárias do arquivo) e só então executa tudo de uma vez, de forma paralela.
Benchmark: Pandas vs Polars na prática
Uma forma de avaliar a diferença de desempenho entre Pandas e Polars é observar benchmarks específicos para cargas de trabalho analíticas. Um deles é o PDS-H (Polars Decision Support), desenvolvido pelo próprio projeto Polars e derivado do TPC-H, um benchmark amplamente utilizado para avaliar sistemas de suporte à decisão. É importante destacar que o PDS-H é uma adaptação voltada à comparação de ferramentas de DataFrame e engines analíticas e, portanto, seus resultados não devem ser tratados como resultados oficiais do TPC-H.
Foram testados o Polars, Pandas, DuckDB, Dash e PySpark, os resultados publicados utilizaram uma máquina com 96 vCPUs e 192 GB de memória, o Polars apresentou desempenho significativamente superior ao Pandas em determinadas cargas do PDS-H. No cenário com escala 10, equivalente a aproximadamente 10 GB de dados, o tempo total reportado foi de 3,89 segundos para o Polars utilizando seu engine de streaming e 365,71 segundos para o Pandas. Nesse cenário específico, isso representa uma diferença de aproximadamente 94 vezes no tempo total de execução.
Entretanto, esses números devem ser interpretados dentro do contexto em que foram obtidos. O resultado depende do hardware utilizado, das versões das bibliotecas, da configuração do teste, do tamanho dos dados, das consultas executadas e do modo de processamento utilizado. Além disso, o benchmark é publicado pelo próprio projeto Polars, o que torna importante evitar generalizações a partir de seus resultados. O próprio projeto ressalta que os resultados podem variar de acordo com o caso de uso e o hardware.
Isso não significa que o benchmark deixe de ser útil. Pelo contrário: ele ajuda a demonstrar uma tendência importante. À medida que o volume e a complexidade das operações aumentam, características como execução paralela, otimização do plano de execução e processamento em streaming podem proporcionar vantagens significativas ao Polars. Em datasets pequenos, porém, essa diferença tende a ser muito menor e pode deixar de ser relevante dependendo da operação realizada.
Polars é sempre mais rápido que Pandas?
Não necessariamente. Os números do benchmark anterior representam cenários bem específicos — consultas analíticas pesadas, rodando sobre datasets grandes, em máquinas com vários núcleos disponíveis. Fora desse contexto, ou seja, em conjunto de dados bem pequeno, a vantagem do Polars pode ser bem menor, inexistente ou, em alguns casos pontuais, até reversa.
A diferença de performance entre as duas bibliotecas depende de uma combinação de fatores: o tamanho do dataset (com poucas linhas, o overhead de paralelização do Polars pode não compensar), o tipo de operação (agregações e joins tendem a se beneficiar mais do paralelismo do que operações simples de indexação), o formato dos dados (ler um Parquet nativo em Arrow é mais vantajoso para o Polars do que, por exemplo, um CSV mal formatado), o número de núcleos disponíveis na máquina , se o código usa o modo eager ou lazy (o ganho de otimização automática só existe no modo lazy) e a complexidade do pipeline (quanto mais etapas encadeadas, mais espaço o otimizador de query do Polars tem para atuar).
Na prática, isso significa que vale a pena testar as duas bibliotecas com os próprios dados e o próprio pipeline antes de decidir migrar. Benchmarks genéricos são um bom indicativo de tendência, mas não substituem uma medição real no cenário de uso de cada projeto.
Pandas ou Polars: qual escolher?
Não existe uma resposta única. Faz sentido continuar com o Pandas se você trabalha com datasets pequenos ou médios, depende fortemente de bibliotecas do ecossistema que só suportam Pandas nativamente (algumas libs de visualização e machine learning ainda esperam um DataFrame do Pandas), ou já tem uma base de código grande e estável construída em cima dele. Por outro lado, vale a pena considerar o Polars quando performance e uso de memória são gargalos reais, quando você trabalha com datasets grandes, ou quando está começando um projeto novo e pode escolher a ferramenta mais moderna sem herdar dívida técnica.
Vale lembrar que as duas ferramentas não são mutuamente exclusivas: é comum usar Polars para etapas pesadas de processamento e converter o resultado final para Pandas (df.to_pandas()) quando for necessário integrar com alguma biblioteca específica do ecossistema Pandas.
Comentários (0)
Seja o primeiro a comentar.