Hiperparâmetros em Machine Learning: o que são e como ajustá-los
 Rael Rodrigues
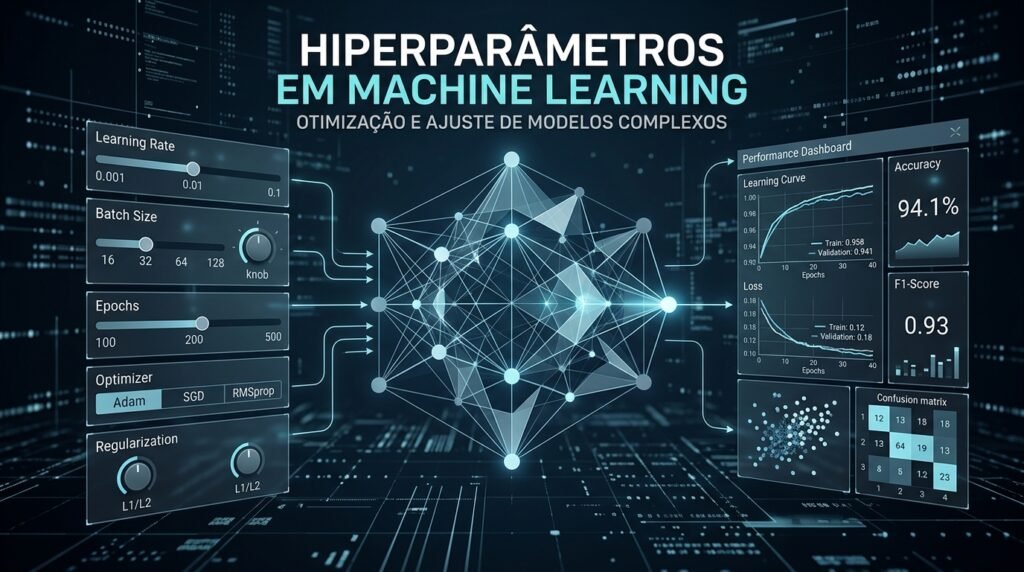
Ao treinar um modelo de machine learning, existem dois tipos de “configurações” que definem seu comportamento: os parâmetros e os hiperparâmetros. Enquanto os parâmetros são aprendidos automaticamente pelo modelo durante o treinamento (como os pesos de uma rede neural ou os coeficientes de uma regressão linear), os hiperparâmetros são definidos pelo desenvolvedor ou por processos de otimização e controlam como o treinamento acontece.
Em outras palavras: os parâmetros são o que o modelo aprende; os hiperparâmetros são as escolhas que você faz sobre como o modelo vai aprender.
Por que os hiperparâmetros são importantes?
A escolha dos hiperparâmetros pode ser a diferença entre um modelo medíocre e um modelo de alta performance, mesmo usando exatamente os mesmos dados e o mesmo algoritmo. Eles controlam o equilíbrio entre underfitting e overfitting, já que hiperparâmetros mal ajustados podem fazer o modelo memorizar os dados de treino ou não aprender padrões suficientes. Também afetam diretamente o tempo e o custo computacional do treinamento, pois alguns deles determinam quanto tempo o processo vai levar e quanta memória será consumida. Além disso, determinam a capacidade do modelo, ou seja, o quão complexo ou simples ele pode se tornar para representar os dados, e influenciam a convergência do treinamento — em algoritmos baseados em otimização, hiperparâmetros como a taxa de aprendizado definem se o modelo vai convergir para uma boa solução, oscilar sem melhorar, ou “explodir” numericamente.
Por isso, o processo de tuning de hiperparâmetros (ajuste de hiperparâmetros) é uma etapa essencial — e muitas vezes a que mais consome tempo — no desenvolvimento de um modelo.
Quando ajustar os hiperparâmetros?
Nem sempre é necessário fazer uma busca extensiva. Vale a pena investir tempo nesse ajuste principalmente quando o modelo com valores padrão não performa bem, ou seja, quando as métricas como acurácia, F1-score ou RMSE ficam abaixo do esperado — nesse caso, ajustar hiperparâmetros costuma ser um dos primeiros passos. Também é importante ajustar quando há sinais de overfitting ou underfitting, como quando o modelo vai muito bem no treino mas mal na validação, situação em que hiperparâmetros de regularização podem ajudar. Antes de colocar o modelo em produção, um ajuste fino final geralmente é feito para extrair o máximo de performance possível. Ao mudar o conjunto de dados também é preciso revisitar os hiperparâmetros, já que valores ótimos para um dataset raramente são ótimos para outro, e cada novo conjunto de dados costuma exigir um novo ajuste. Por fim, ao comparar algoritmos diferentes, cada um deve estar com seus hiperparâmetros otimizados para que a comparação seja justa, senão ela fica enviesada.
Vale lembrar que ajustar hiperparâmetros tem custo, tanto em tempo quanto em poder computacional, então em projetos com prazo curto ou dados simples, valores padrão bem escolhidos já podem ser suficientes.
Principais técnicas de ajuste (tuning)
Existem algumas abordagens comuns para encontrar bons hiperparâmetros. O Grid Search testa todas as combinações possíveis dentro de um conjunto pré-definido de valores — é exaustivo, mas pode ser lento em espaços de busca grandes. O Random Search testa combinações aleatórias dentro de um intervalo e costuma ser mais eficiente que o Grid Search quando há muitas combinações possíveis. Já a otimização Bayesiana usa os resultados de tentativas anteriores para escolher, de forma mais inteligente, quais combinações testar em seguida, sendo implementada por ferramentas como Optuna e Hyperopt, que oferecem diferentes estratégias de busca. Independentemente da técnica escolhida, é comum combiná-la com validação cruzada (cross-validation), que garante que o hiperparâmetro escolhido generalize bem, e não apenas funcione bem em uma divisão específica dos dados.
O papel do conjunto de validação no ajuste de hiperparâmetros
Ao treinar um modelo, é comum dividir os dados disponíveis em pelo menos dois conjuntos: treino e teste. O conjunto de treino é usado para o modelo aprender seus parâmetros, enquanto o conjunto de teste é reservado para avaliar o desempenho final, simulando como o modelo se comportaria em dados nunca vistos. No entanto, quando o objetivo é ajustar hiperparâmetros, usar o conjunto de teste para essa tarefa é um erro comum e perigoso: se você escolhe os hiperparâmetros observando o desempenho no teste, está indiretamente “vazando” informação desse conjunto para o processo de treinamento, e a avaliação final deixa de refletir a capacidade real de generalização do modelo.
É exatamente para resolver esse problema que existe o conjunto de validação. Ele é uma terceira fatia dos dados, separada tanto do treino quanto do teste, usada especificamente para comparar diferentes combinações de hiperparâmetros e escolher a que apresenta o melhor desempenho antes de qualquer avaliação final. Dessa forma, o fluxo típico passa a ser: o modelo é treinado no conjunto de treino, os hiperparâmetros são ajustados observando o desempenho no conjunto de validação, e só depois de escolhida a melhor configuração o modelo é avaliado uma única vez no conjunto de teste, que permanece “intocado” durante todo o processo de ajuste.
Essa separação é importante porque garante uma avaliação mais honesta do modelo. Sem um conjunto de validação dedicado, existe o risco de o modelo (e os hiperparâmetros escolhidos) se ajustarem excessivamente às particularidades do conjunto de teste, um fenômeno às vezes chamado de “overfitting no conjunto de teste”, mesmo que o modelo nunca tenha sido treinado diretamente nesses dados. Isso é especialmente relevante quando muitas combinações de hiperparâmetros são testadas, como em um Grid Search ou Random Search: quanto mais combinações são avaliadas, maior a chance de encontrar, por puro acaso, uma configuração que parece boa em um conjunto específico de dados, mas que não generaliza bem para dados novos.
Em conjuntos de dados pequenos, separar um conjunto de validação fixo pode reduzir demais os dados disponíveis para treino. Nesses casos, a alternativa mais usada é a validação cruzada (cross-validation), especialmente o método k-fold, que divide os dados de treino em várias partes (ou “folds”), treina o modelo em algumas partes e valida nas restantes, repetindo esse processo várias vezes e alternando quais partes são usadas para validação. Essa abordagem aproveita melhor os dados disponíveis e fornece uma estimativa mais robusta do desempenho do modelo para cada combinação de hiperparâmetros testada, sendo o método utilizado por ferramentas como o GridSearchCV, mostrado mais adiante neste artigo.
Hiperparâmetros por tipo de algoritmo
Para cada algoritmo abaixo, você encontra uma breve explicação do que ele faz, os principais hiperparâmetros com seus valores mais comuns, um exemplo de uso prático e um trecho de código mostrando como aplicá-los em Python (usando principalmente a biblioteca scikit-learn). Segue link se quiser conhecer um pouco mais sobre ajustes de hiperparâmetros do Scikit-learn
1. Regressão Linear
O que faz: modela a relação entre uma variável dependente numérica e uma ou mais variáveis independentes, ajustando uma reta (ou hiperplano) que minimiza o erro entre os valores previstos e os reais. É usada para problemas de regressão, como prever preços, vendas ou temperaturas.
| Hiperparâmetro | O que faz | Exemplos de Valores |
| fit_intercept | Define se o modelo deve calcular o termo de intercepto (viés) ou assumir que a reta passa pela origem. | True / False |
| copy_X | Define se os dados de entrada devem ser copiados antes do ajuste (evita sobrescrever o array original). | True / False |
| positive | Força os coeficientes estimados a serem apenas positivos. | True / False |
Exemplo de uso: prever o preço de imóveis com base em metragem, número de quartos e localização. Se todas as variáveis do problema fazem sentido apenas com valores positivos (como preço ou metragem), usar positive=True pode ajudar o modelo a gerar coeficientes mais interpretáveis.
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

modelo = LinearRegression(
      fit_intercept=True, # calcula o intercepto
      positive=False, # permite coeficientes negativos
      n_jobs=-1 # usa todos os núcleos disponíveis
)

modelo.fit(X_train, y_train)

previsoes = modelo.predict(X_test)
Observação: a Regressão Linear “pura” (LinearRegression) não possui hiperparâmetros de regularização. Quando o objetivo é controlar overfitting penalizando coeficientes altos, normalmente se usa uma variante regularizada, como Ridge, Lasso ou ElasticNet, que introduzem hiperparâmetros próprios como alpha (força da regularização) e l1_ratio (proporção entre L1 e L2, no caso do Elastic Net).
2. Regressão Logística
O que faz: apesar do nome, é usada para classificação (não regressão). Estima a probabilidade de uma observação pertencer a uma classe, usando a função sigmoide para transformar uma combinação linear das variáveis em um valor entre 0 e 1.
| Hiperparâmetro | O que faz | Exemplos de Valores |
| C | Inverso da força de regularização. Valores baixos aumentam a regularização (modelo mais simples); valores altos reduzem a regularização (modelo mais flexível). | 0.001 a 100 (ex.: 0.01, 0.1, 1, 10) |
| penalty | Tipo de regularização aplicada: L1 (Lasso, favorece esparsidade), L2 (Ridge, padrão) ou elasticnet. | l1, l2, elasticnet, none |
| solver | Algoritmo de otimização usado para encontrar os coeficientes. | lbfgs, liblinear, saga, newton-cg |
| max_iter | Número máximo de iterações para o solver convergir. | 100 a 1000 |
| class_weight | Ajusta o peso das classes, útil em datasets desbalanceados. | None, balanced |
Exemplo de uso: classificar e-mails como spam ou não spam. Em um dataset desbalanceado (poucos spams), usar class_weight=’balanced’ ajuda o modelo a não ignorar a classe minoritária.
from sklearn.linear_model import LogisticRegression

modelo = LogisticRegression(
    C=1.0,                   # inverso da regularização
    penalty='l2',            # tipo de regularização
    solver='lbfgs',          # algoritmo de otimização
    max_iter=500,            # iterações máximas
    class_weight='balanced'  # lida com classes desbalanceadas
)

modelo.fit(X_train, y_train)
probabilidades = modelo.predict_proba(X_test)
3. XGBoost
O que faz: o XGBoost é um algoritmo de ensemble baseado em árvores de decisão que utiliza a ideia de Gradient Boosting. Em vez de criar uma única árvore para realizar as previsões, ele constrói várias árvores sequencialmente, fazendo com que cada nova árvore procure corrigir os erros cometidos pelas árvores anteriores.
O XGBoost é bastante utilizado em problemas de classificação e regressão e se tornou uma das implementações mais conhecidas de Gradient Boosting.
| Hiperparâmetro | O que faz | Exemplos de Valores |
| learning_rate (eta) | Controla o peso da contribuição de cada árvore no resultado final. | 0.01 a 0.3 |
| n_estimators | Número de árvores (boosting rounds). | 100 a 1000 |
| max_depth | Profundidade máxima de cada árvore. | 3 a 10 |
| subsample | Fração das amostras usada em cada árvore, para reduzir overfitting. | 0.5 a 1.0 |
| colsample_bytree | Fração das variáveis (colunas) usada em cada árvore. | 0.5 a 1.0 |
| reg_alpha | controla a regularização L1 aplicada aos pesos das folhas, podendo incentivar modelos mais esparsos. | 0 a 10 |
| reg_lambda | controla a regularização L2 dos pesos das folhas, ajudando a controlar a complexidade do modelo. | 0 a 10 |
| gamma | Ganho mínimo de perda exigido para fazer uma nova divisão em um nó. | 0 a 5 |
Exemplo de uso: previsão de demanda de produtos em varejo. Ajustar max_depth para valores entre 4 e 6, junto com subsample e colsample_bytree em torno de 0.8, costuma equilibrar bem performance e generalização.
from xgboost import XGBClassifier

modelo = XGBClassifier(
    learning_rate=0.1,      # taxa de aprendizado (eta)
    n_estimators=500,       # número de árvores
    max_depth=5,            # profundidade máxima
    subsample=0.8,          # fração de amostras por árvore
    colsample_bytree=0.8,   # fração de variáveis por árvore
    reg_alpha=0.1,          # regularização L1
    reg_lambda=1.0,         # regularização L2
    gamma=0                 # ganho mínimo para nova divisão
)

modelo.fit(X_train, y_train)
4. K-Means (Clusterização)
O que faz: agrupa os dados em “K” clusters, atribuindo cada ponto ao cluster cujo centróide (ponto médio) está mais próximo, e recalculando os centróides iterativamente até estabilizar. É um algoritmo não supervisionado, usado para segmentação de dados.
| Hiperparâmetro | O que faz | Exemplos de Valores |
| n_clusters (K) | Número de clusters a serem formados — geralmente o hiperparâmetro mais crítico do algoritmo. | 2 a 20 (definido via método do cotovelo ou silhouette score) |
| init | Método de inicialização dos centróides. | k-means++, random |
| max_iter | Número máximo de iterações permitidas para convergência. | 100 a 500 |
Exemplo de uso: segmentação de clientes para campanhas de marketing. O número de clusters (n_clusters) costuma ser definido testando valores de 2 a 10 e escolhendo o ponto de “cotovelo” no gráfico de erro (inércia). Em algoritmos não supervisionados, não existe uma variável-alvo conhecida que permita avaliar diretamente se uma configuração é “melhor” da mesma maneira que em problemas supervisionados.
from sklearn.cluster import KMeans

modelo = KMeans(
    n_clusters=5,       # número de clusters
    init='k-means++',   # inicialização inteligente dos centróides
    max_iter=300        # iterações máximas até convergir
)

modelo.fit(X)
grupos = modelo.labels_
Ajustando hiperparâmetros automaticamente com Grid Search
Além de definir os hiperparâmetros manualmente, é possível automatizar a busca pela melhor combinação usando o GridSearchCV do scikit-learn, que testa várias combinações e escolhe a melhor com base em validação cruzada. O exemplo abaixo mostra isso aplicado a uma Random Forest:
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV

parametros = {
    'n_estimators': [100, 300, 500],
    'max_depth': [5, 10, 15, None],
    'max_features': ['sqrt', 'log2']
}

busca = GridSearchCV(
    estimator=RandomForestClassifier(),
    param_grid=parametros,
    cv=5,                 # validação cruzada com 5 divisões
    scoring='f1',
    n_jobs=-1             # usa todos os núcleos disponíveis
)

busca.fit(X_train, y_train)

print(busca.best_params_)   # melhor combinação encontrada
print(busca.best_score_)    # melhor pontuação obtida
Boas práticas ao ajustar hiperparâmetros
É recomendável começar com os valores padrão das bibliotecas, como scikit-learn e XGBoost, já que eles costumam ser um bom ponto de partida antes de qualquer ajuste mais fino. Usar validação cruzada é essencial para evitar escolher hiperparâmetros que só funcionam bem por acaso em uma divisão específica dos dados. Também vale priorizar os hiperparâmetros de maior impacto antes de otimizar os secundários — no XGBoost, por exemplo, learning_rate e max_depth costumam ter mais impacto que gamma. É importante monitorar o custo computacional, já que buscas exaustivas em espaços grandes podem ser inviáveis, preferindo Random Search ou otimização Bayesiana quando o espaço de busca for amplo. Por fim, documentar os experimentos com ferramentas como MLflow ou Weights & Biases ajuda a rastrear quais combinações foram testadas e seus resultados.
Conclusão
Os hiperparâmetros são um dos elementos mais importantes — e muitas vezes subestimados — no processo de construção de modelos de machine learning. Eles não são aprendidos diretamente como os parâmetros do modelo; normalmente são definidos manualmente ou selecionados por métodos automatizados de otimização, e têm impacto direto na capacidade de generalização, no tempo de treinamento e na performance final. Métodos como Grid Search, Random Search e otimização Bayesiana ajudam a explorar diferentes configurações e encontrar combinações que apresentem bom desempenho para um determinado problema. Entender o papel de cada hiperparâmetro, os valores típicos usados na prática, como aplicá-los em código e como eles se comportam em diferentes algoritmos é essencial para quem deseja ir além dos resultados “padrão” e extrair o máximo potencial de um modelo.
Comentários (0)
Seja o primeiro a comentar.