Quais habilidades um Cientista de Dados precisa dominar?
 Rael Rodrigues
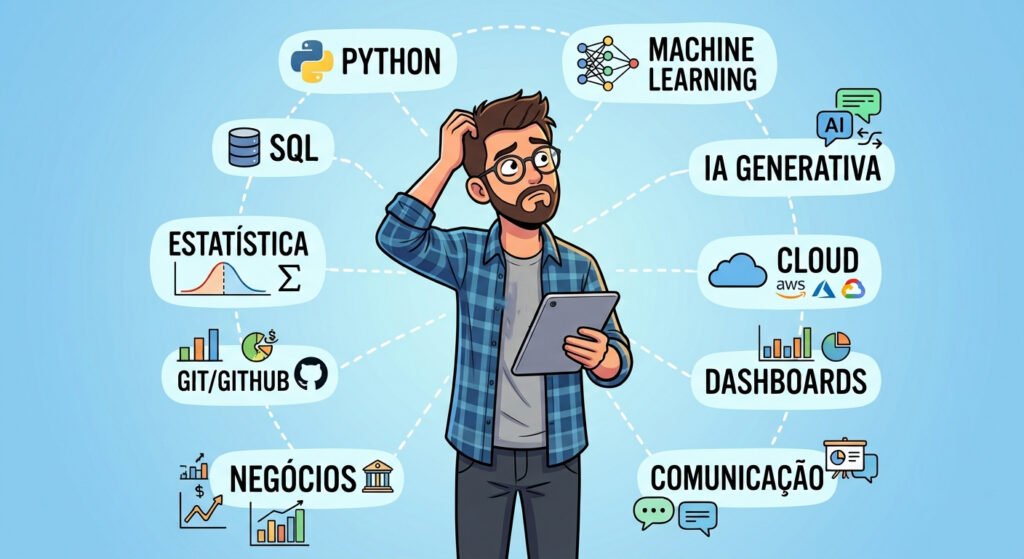
A Ciência de Dados se consolidou como uma das profissões mais estratégicas da economia digital. Empresas de todos os setores dependem de profissionais capazes de transformar grandes volumes de informação em decisões concretas, e isso exige uma combinação pouco comum de conhecimentos: estatística, programação, negócios e comunicação convivendo na mesma pessoa. Não existe um caminho único para chegar lá, mas existem competências que aparecem, de forma recorrente, em qualquer vaga séria de mercado. Este artigo organiza essas competências em blocos — formação, cursos e certificações, ferramentas, conceitos e frameworks — para ajudar quem está construindo ou reforçando essa trajetória.
Formação: qual base acadêmica realmente importa
Não existe uma graduação obrigatória para se tornar Cientista de Dados, mas existe uma base de conhecimento que praticamente todo profissional bem-sucedido carrega, venha ela de onde vier. Cursos de Ciência da Computação, Estatística, Matemática, Engenharia ou Economia costumam oferecer esse alicerce de forma mais natural, porque já trabalham com lógica, modelagem matemática e pensamento analítico desde o início.
Dito isso, o mercado está cada vez mais aberto a trajetórias não lineares. Profissionais vindos de Administração, Física, Biologia ou até Ciências Sociais têm conseguido migrar para a área com sucesso, desde que compensem as lacunas técnicas com estudo dirigido e projetos práticos. O que pesa na balança, no fim das contas, não é o diploma em si, mas a capacidade comprovada de aplicar estatística e programação para resolver problemas reais de negócio.
Uma pós-graduação, mestrado ou MBA em Ciência de Dados, Business Analytics ou Inteligência Artificial pode acelerar essa jornada, principalmente para quem busca cargos mais seniores ou posições de liderança técnica.
Mas vale um alerta: um bom portfólio costuma valer mais do que diversas certificações. Ter projetos publicados no GitHub, participar de competições do Kaggle, desenvolver aplicações utilizando Python e Machine Learning e documentar os resultados demonstra experiência prática e facilita a avaliação por recrutadores.
Cursos e certificações que têm peso no mercado
Certificações não substituem experiência, mas cumprem um papel importante: validam conhecimento técnico de forma objetiva e ajudam a organizar o próprio aprendizado, especialmente para quem está migrando de carreira. Algumas se destacam pela reputação e pela aderência ao que as empresas realmente cobram no dia a dia.
Como escolher a certificação certa?
Ao pesquisar sobre certificações em Ciência de Dados, é comum encontrar recomendações de credenciais oferecidas por empresas como Microsoft, Google, Amazon, IBM e Databricks. À primeira vista, pode parecer que o ideal é obter todas elas, mas essa não é a estratégia mais eficiente. Na prática, cada uma faz parte de um ecossistema tecnológico específico, e o mais importante é construir uma trilha de aprendizado coerente com a plataforma que você pretende utilizar no mercado.
A IBM Data Science Professional Certificate é uma excelente porta de entrada para quem está iniciando na área, pois apresenta os principais fundamentos da Ciência de Dados, incluindo Python, SQL, estatística, visualização de dados e Machine Learning. Após adquirir essa base, o próximo passo é escolher uma plataforma de computação em nuvem para se especializar.
Se o seu objetivo é trabalhar em empresas que utilizam tecnologias da Microsoft, a trilha mais indicada é seguir para a certificação Microsoft Certified: Azure Data Scientist Associate (DP-100). Já quem pretende atuar em organizações que utilizam a infraestrutura do Google Cloud pode optar pela Google Professional Data Engineer. Para empresas que adotam a Amazon Web Services, a certificação AWS Certified Machine Learning – Specialty costuma ser a escolha mais adequada.
Depois de consolidar seus conhecimentos na plataforma escolhida, vale investir em certificações mais especializadas que complementem sua formação. A Databricks Certified Data Scientist é bastante valorizada por empresas que trabalham com Apache Spark, arquiteturas Lakehouse e projetos de Machine Learning em larga escala. Como a plataforma Databricks pode ser utilizada em diferentes provedores de nuvem, essa certificação representa um excelente complemento para profissionais que desejam atuar em projetos modernos de Engenharia e Ciência de Dados. Outra certificação de grande reconhecimento é a Certified Analytics Professional (CAP), voltada para profissionais que desejam validar conhecimentos em todo o ciclo analítico, desde a definição do problema de negócio até a comunicação dos resultados, sem estar vinculada a uma tecnologia específica. Já a SAS Certified Data Scientist é uma excelente opção para quem pretende atuar em setores como bancos, seguradoras, saúde e governo, onde as soluções da SAS ainda são amplamente utilizadas em projetos de Analytics e Ciência de Dados. Em conjunto, essas certificações permitem ao profissional aprofundar seus conhecimentos em tecnologias, metodologias e práticas amplamente reconhecidas pelo mercado, independentemente do ecossistema de nuvem escolhido.
Em vez de acumular certificações de diferentes fornecedores, a estratégia mais inteligente é aprofundar-se em um único ecossistema e construir uma especialização consistente. Essa abordagem reduz o tempo de estudo, evita conteúdos redundantes e demonstra aos recrutadores que o profissional possui domínio real das ferramentas utilizadas naquele ambiente. Conforme a carreira evolui e surgem novas necessidades profissionais, outras certificações podem ser adicionadas para ampliar a atuação, mas sempre como complemento de uma base sólida, e não como objetivo principal.
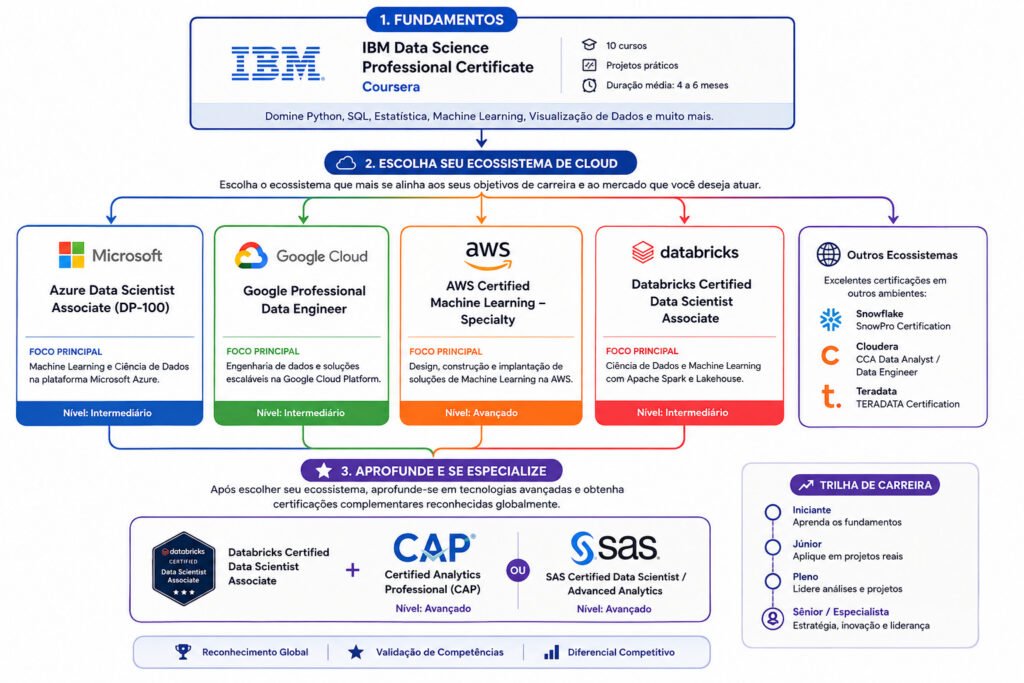
Trilha das certificações
Ferramentas que todo Cientista de Dados deveria dominar
Na prática, o dia a dia da profissão gira em torno de um conjunto relativamente estável de ferramentas, mesmo com toda a efervescência de novidades no mercado.
Python é hoje a linguagem de referência da área, por sua sintaxe acessível e pelo ecossistema maduro de bibliotecas — pandas e NumPy para manipulação de dados, scikit-learn para machine learning tradicional, e frameworks como TensorFlow e PyTorch para deep learning.
SQL continua sendo, e provavelmente continuará sendo por muito tempo, a linguagem universal para consultar e manipular dados armazenados em bancos relacionais. Como cientista de dados, é comum precisar lidar com grandes volumes de informações armazenadas em bancos de dados, e SQL é uma das linguagens mais usadas para isso. Nenhuma quantidade de sofisticação em machine learning substitui a habilidade básica de escrever uma boa query.
À medida que os projetos de Ciência de Dados se tornam mais complexos e colaborativos, o domínio de ferramentas de versionamento passa a ser essencial. O Git permite controlar alterações no código, recuperar versões anteriores e trabalhar em equipe de forma organizada, enquanto o GitHub facilita o compartilhamento de projetos, a revisão de código e a colaboração entre desenvolvedores e cientistas de dados. Além de melhorar a produtividade, manter um portfólio atualizado no GitHub é uma excelente forma de demonstrar experiência prática e conhecimento técnico para recrutadores.
Ferramentas de visualização de dados, como Tableau e Power BI, ajudam a traduzir análises complexas em painéis compreensíveis para públicos não técnicos — uma etapa frequentemente subestimada, mas essencial para que o trabalho analítico realmente influencie decisões.
Jupyter Notebook (ou variações como Google Colab) segue como o ambiente padrão para experimentação e prototipagem, enquanto ferramentas de preparação de dados — como Tableau Prep Builder e o próprio pandas — ajudam a lidar com uma das etapas mais demoradas do trabalho: limpar e organizar dados brutos antes de qualquer análise.
Abaixo, deixo uma tabela com as ferramentas entre as essenciais até as que geram diferencial.
| Essencial | Muito importante | Diferencial |
|---|---|---|
| Python | Cloud | Databricks |
| SQL | Git | TensorFlow |
| Estatística | Power BI | Kafka |
| Machine Learning | Comunicação | Kubeflow |
Conceitos que sustentam o trabalho técnico
Ferramentas mudam com o tempo; conceitos bem consolidados tendem a durar bem mais. Um Cientista de Dados precisa de conforto real com estatística e matemática — distribuições, testes de hipóteses, regressão, probabilidade e álgebra linear formam a base sobre a qual quase tudo o resto é construído. Um sólido conhecimento em estatística e matemática ajuda a fazer análises de dados e a criar modelos preditivos, e vale a pena compreender conceitos como distribuições estatísticas, testes de hipóteses e regressões.
O domínio de machine learning vai além de saber chamar uma função de biblioteca: envolve entender quando usar regressão, árvores de decisão, redes neurais, classificadores ou sistemas de recomendação, e por quê. O cientista cria modelos matemáticos, treina algoritmos, testa desempenho e ajusta variáveis, sendo que entre os modelos mais utilizados estão regressões, árvores de decisão, redes neurais, classificadores e sistemas de recomendação.
A etapa de preparação e limpeza de dados costuma consumir a maior parte do tempo real de um projeto de dados, mesmo sendo a menos glamurosa. Trata-se de uma parte essencial do fluxo de trabalho de análise, e independentemente da ferramenta utilizada, o profissional precisa entender as tarefas envolvidas e como elas se relacionam com o restante do trabalho de ciência de dados.
Vale destacar também o pensamento crítico como competência conceitual, não apenas comportamental. Isso envolve decompor problemas complexos em partes gerenciáveis, questionar premissas, identificar vieses nos dados e nas análises, e interpretar resultados com ceticismo saudável — indo além de simplesmente executar análises, para perguntar se os dados fazem sentido, o que pode estar faltando e quais são as limitações de uma conclusão. Esse hábito protege contra o erro clássico de confundir correlação com causalidade e evita decisões de negócio baseadas em conclusões frágeis.
Compreender os princípios matemáticos por trás dos algoritmos também importa mais do que parece à primeira vista. Entender os princípios e algoritmos subjacentes é fundamental para usar os recursos de análise disponíveis, especialmente quando é preciso adaptar ou criar novas soluções para problemas específicos.
Produzir análises precisas é apenas parte do trabalho de um cientista de dados. Tão importante quanto encontrar os insights é saber comunicá-los de forma clara e convincente. O storytelling com dados consiste em transformar números, gráficos e modelos estatísticos em uma narrativa que facilite a compreensão do problema, das descobertas e das recomendações. Quando bem aplicado, ele ajuda gestores e demais stakeholders a tomar decisões mais rápidas e fundamentadas, aumentando o impacto das análises realizadas.
Modelos analíticos só geram valor quando produzem resultados mensuráveis para a empresa. Por isso, um cientista de dados deve compreender métricas de negócio, como taxa de conversão, retenção de clientes, ticket médio, churn e retorno sobre investimento (ROI), além de dominar técnicas de experimentação, como os testes A/B. Esses testes permitem comparar diferentes versões de um produto, serviço ou estratégia para identificar, com base em evidências estatísticas, qual delas gera melhores resultados. Essa capacidade de validar hipóteses e medir o impacto das decisões é uma das habilidades que mais aproximam a Ciência de Dados dos objetivos do negócio.
Habilidades comportamentais: o lado que raramente aparece nas vagas
Por fim, vale reforçar que nenhuma lista de ferramentas ou certificações substitui certas competências comportamentais. Comunicação clara para traduzir resultados técnicos para públicos não técnicos, capacidade de trabalhar em equipes multidisciplinares, curiosidade genuína para explorar dados sem hipóteses prontas e paciência para lidar com bases de dados imperfeitas fazem parte do pacote completo. Tanto o conhecimento técnico quanto as competências comportamentais podem ser aprendidos em ambiente educacional ou durante treinamentos de capacitação profissional, e desenvolvê-los exige um processo contínuo de aprendizado, paciência e dedicação.
Conclusão
Tornar-se um Cientista de Dados completo é menos sobre acumular certificados e mais sobre construir, de forma consistente, uma combinação sólida entre fundamentos estatísticos, domínio técnico de ferramentas, pensamento crítico e capacidade de comunicação. A boa notícia é que esse caminho pode ser percorrido por rotas bem diferentes — graduação tradicional, bootcamps, cursos online ou migração de carreira — desde que sustentado por prática constante, projetos reais e disposição genuína para continuar aprendendo em uma área que não para de se reinventar.
A Ciência de Dados é uma área em constante evolução. Novas ferramentas surgem todos os anos, mas os fundamentos permanecem os mesmos. Mais do que aprender ferramentas específicas, o verdadeiro diferencial está na capacidade de resolver problemas reais utilizando dados.
Comentários (0)
Seja o primeiro a comentar.