O que é um Lakehouse? Entenda o formato Delta e a evolução da arquitetura de dados
 Rael Rodrigues
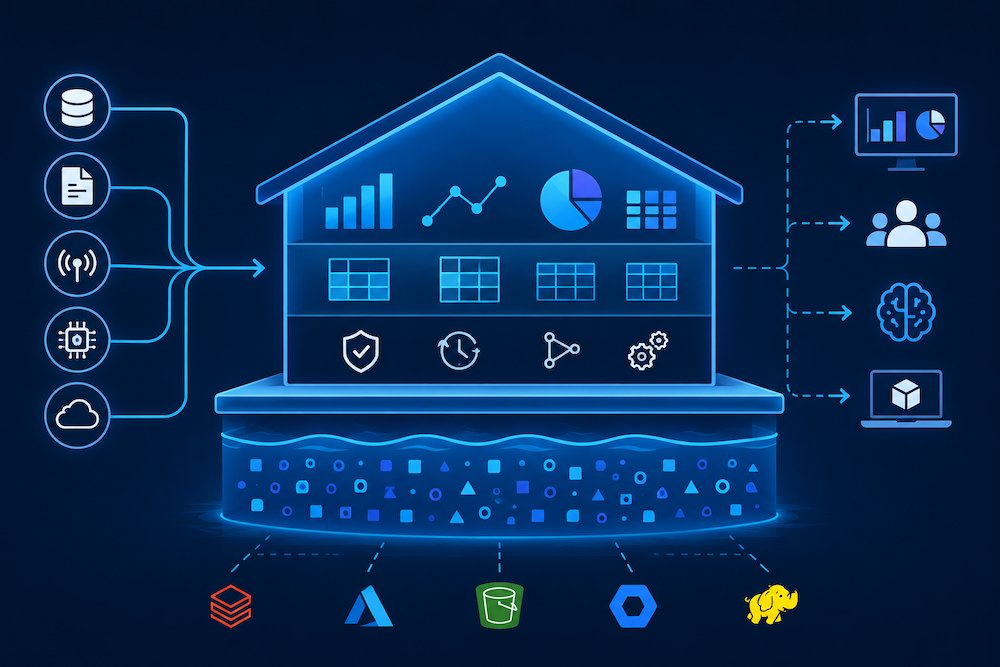
Nos últimos anos, o termo Lakehouse tornou-se um dos principais assuntos da Engenharia de Dados. Junto com ele, outro nome passou a aparecer com frequência: Delta Lake. Mas afinal, o que esses conceitos significam e por que tantas empresas estão migrando suas arquiteturas para esse modelo? Neste artigo, você entenderá como surgiu o Lakehouse, qual é o papel do Delta Lake e por que essa combinação está transformando a forma como organizações armazenam, processam e analisam grandes volumes de dados.
Glossário rápido
Antes de entrar nos detalhes, aqui vai um resumo direto de cada termo — para consultar sempre que precisar e deixar esse artigo o mais claro possível:
- Data Warehouse: um repositório de dados estruturados, organizado em tabelas com schema fixo, otimizado para consultas rápidas e relatórios de negócio.
- Data Lake: um repositório de armazenamento barato (geralmente em nuvem) que guarda dados de qualquer tipo — estruturado, semiestruturado ou bruto — sem exigir organização prévia.
- Lakehouse: uma arquitetura que une o custo baixo e a flexibilidade do Data Lake com a confiabilidade e a performance de consulta de um Data Warehouse.
- Formato Delta: a especificação técnica de como os dados e as transações são organizados em disco (arquivos Parquet + log de transações), que dá origem às tabelas Delta.
- Delta Lake: o projeto open-source, criado pela Databricks, que implementa o formato Delta e fornece as ferramentas para ler, escrever e gerenciar tabelas nesse formato.
Na prática, Formato Delta e Delta Lake são a mesma coisa, a distinção só importa em contexto bem técnicos, ao longo desse artigo vou usar o termo Formato Delta.
Para entender o Lakehouse, primeiro precisamos relembrar dois conceitos
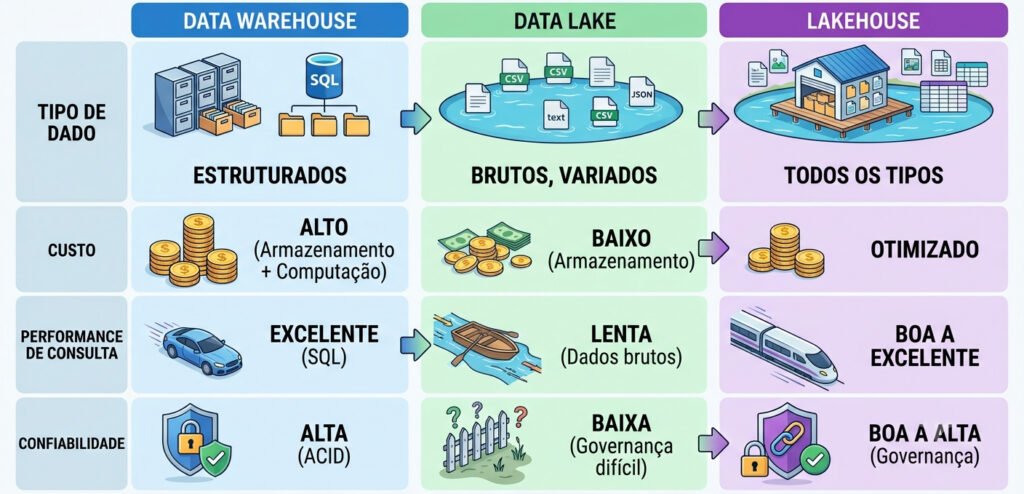
Data Warehouse (armazém de dados): É um repositório estruturado, otimizado para consultas rápidas e relatórios. Os dados chegam já organizados em tabelas, com schema bem definido. É extremamente confiável e performático para análises de negócio, mas tem um custo alto e pouca flexibilidade para lidar com dados não estruturados (imagens, vídeos, logs, JSON, etc.). Seu principal uso é em projetos de análise de dados. Os dados saem do banco transacional, passa pelo processo de ETL e chegam ao Data Warehouse prontos para consumo por uma ferramenta de BI como Power BI, Qlik Sense, Tableu, etc.
Data Lake (lago de dados): Surgiu para resolver justamente a limitação dos Data Warehouse. É um repositório que armazena dados em qualquer formato — estruturado, semiestruturado ou não estruturado — a um custo bem mais baixo, geralmente em serviços de armazenamento em nuvem (como Amazon S3, Azure Data Lake ou Google Cloud Storage). O problema é que, sem controle e organização, o Data Lake vira facilmente um “data swamp” (pântano de dados): tudo lá dentro, mas sem confiabilidade, sem controle de versões e sem garantias de qualidade.
E aí entra o Lakehouse
Foi justamente para resolver essas limitações que surgiu o conceito de Lakehouse, uma arquitetura que combina as principais vantagens dos Data Lakes e dos Data Warehouses em um único ambiente.
O Lakehouse é uma proposta de arquitetura que tenta unir o melhor dos dois mundos:
- O custo baixo e a flexibilidade de um Data Lake (armazenar qualquer tipo de dado, em grande volume, sem depender de um formato rígido).
- A confiabilidade, governança e performance de consulta de um Data Warehouse.
Na prática, isso é possível graças a uma camada de metadados e controle de transações que passa a existir por cima do armazenamento bruto do Data Lake — e é exatamente aí que entra o formato Delta.
Fisicamente, um Lakehouse não é um software, um banco de dados nem um tipo de armazenamento. Trata-se de uma arquitetura em que os dados são armazenados como arquivos, geralmente no formato Apache Parquet, organizados por um formato de tabela, como o formato Delta. Na maioria das implementações modernas, esses arquivos ficam armazenados em serviços de armazenamento em nuvem, como Amazon S3, Azure Data Lake Storage (ADLS), Google Cloud Storage (GCS). Entretanto, também é possível implementar um Lakehouse em ambientes locais, utilizando servidores próprios ou até mesmo um computador para desenvolvimento e testes.
O que é o formato Delta (Delta Lake)?
Embora o conceito de Lakehouse tenha ganhado grande popularidade, um desafio permanecia: como oferecer recursos típicos de bancos de dados, como transações ACID, controle de versões e consistência, utilizando arquivos armazenados em um Data Lake? Foi para resolver esse problema que surgiu o Formato Delta.
O Formato Delta foi criado pela empresa Databricks por volta de 2016 e foi anunciado em abril de 2019 como um projeto de código aberto. Na época, muitas empresas já utilizavam Data Lakes para armazenar grandes volumes de dados em formatos como CSV, JSON e Parquet. Embora essa abordagem fosse barata e escalável, ela apresentava diversas limitações:
- Não havia garantia de consistência durante escritas simultâneas.
- Atualizar ou excluir registros era complexo.
- Não existia controle de versões dos dados.
- Alterações no esquema (schema) podiam quebrar pipelines.
- Arquivos corrompidos ou incompletos podiam ser lidos por outros processos.
Esses problemas eram aceitáveis quando o Data Lake era usado apenas para armazenamento, mas se tornavam críticos à medida que as empresas passaram a utilizá-lo também para análises, Business Intelligence e Machine Learning.
O Formato Delta surgiu justamente para resolver essas limitações, permitindo que um Data Lake tivesse recursos semelhantes aos de um banco de dados, sem perder sua flexibilidade e baixo custo.
Como o Formato Delta é estruturado?
Uma tabela Delta é composta por duas partes principais:
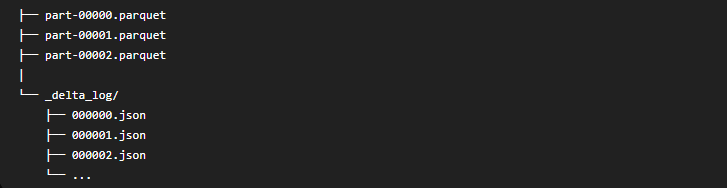
Os arquivos Parquet armazenam os dados propriamente ditos, já o diretório _delta_log contém o histórico de todas as operações realizadas sobre a tabela.
Sempre que alguém:
- insere dados;
- atualiza registros;
- remove informações;
- altera o schema;
o Formato Delta cria um novo registro no log de transações.
Em vez de modificar diretamente os arquivos Parquet, ele registra quais arquivos foram adicionados ou removidos da versão atual da tabela. Esse mecanismo permite reconstruir qualquer versão anterior dos dados.
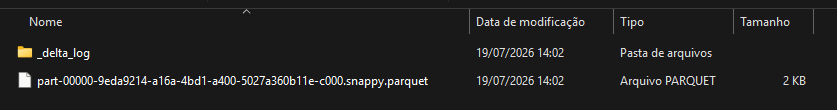
A imagem acima mostra como é um arquivo delta no computador, os dados ficam no arquivo parquet e os logs ficam em um arquivo json dentro da tabela _delta_log.
Como o Formato Delta economiza espaço em disco?
O Formato Delta utiliza arquivos Parquet, que são um formato binário e colunar, que já possuem compressão colunar bastante eficiente.
Na prática, isso significa:
- menor uso de disco;
- menor tráfego na rede;
- consultas mais rápidas;
- leitura apenas das colunas necessárias.
Dependendo do conjunto de dados, a economia de espaço pode ser significativa em comparação com arquivos CSV.
De uma forma bem resumida, o Formato Delta nos permite armazenar dados que podem ser usados para relatórios, como se fossem um arquivo de texto, mas organizados como se fosse um banco de dados e que pode ser consultado por SQL e por bibliotecas do python como a biblioteca deltalake.
As principais capacidades que o Formato Delta entrega são:
1. Transações ACID Assim como um banco de dados tradicional, o Formato Delta garante que as operações de escrita (inserir, atualizar, deletar dados) sejam consistentes, mesmo quando várias pessoas ou processos estão escrevendo ao mesmo tempo. Isso evita problemas comuns em Data Lakes tradicionais, como leituras de dados incompletos ou corrompidos durante uma escrita simultânea.
2. Time Travel (viagem no tempo) O Formato Delta mantém um histórico de versões dos dados. Isso permite consultar como uma tabela estava em um momento específico do passado, ou reverter uma alteração indevida — algo extremamente valioso para auditoria e correção de erros.
3. Schema Enforcement e Schema Evolution O formato garante que os dados gravados sigam uma estrutura esperada (schema enforcement), evitando que dados incorretos “sujem” a tabela. Ao mesmo tempo, permite evoluir esse schema de forma controlada, quando novas colunas precisam ser adicionadas, por exemplo.
4. Unificação de batch e streaming Uma mesma tabela Delta pode ser alimentada tanto por processos em lote (batch) quanto por dados em tempo real (streaming), sem precisar de arquiteturas separadas para cada caso.
5. Performance otimizada O Formato Delta usa técnicas como indexação e compactação de arquivos pequenos para acelerar consultas, resolvendo um problema clássico de Data Lakes: a lentidão causada pelo acúmulo de muitos arquivos pequenos ao longo do tempo.
A arquitetura em camadas: Bronze, Silver e Gold
Um padrão muito comum em implementações de Lakehouse com o Formato Delta é a chamada arquitetura medalhão (medallion architecture), que organiza os dados em três camadas progressivas:
- Bronze: dados brutos, exatamente como chegam da origem (arquivos, APIs, bancos de dados), sem tratamento.
- Silver: dados limpos, validados e já com algum nível de padronização — remoção de duplicidades, correção de tipos, junções básicas.
- Gold: dados agregados e prontos para consumo direto por times de negócio, dashboards ou modelos de machine learning.
Essa organização em camadas ajuda a manter rastreabilidade (é possível voltar à camada Bronze para reprocessar algo, se necessário) e cria um fluxo claro de responsabilidade dentro do pipeline de dados.
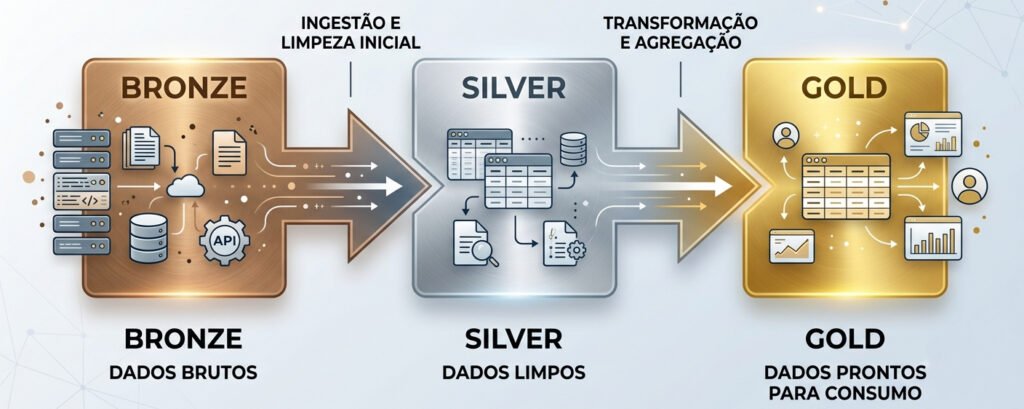
Na prática, o primeiro passo consiste na ingestão dos dados das fontes de origem para a camada Bronze, onde eles são armazenados no formato Delta praticamente da mesma forma como foram recebidos. Em seguida, um processo de transformação move os dados da camada Bronze para a camada Silver, realizando operações como remoção de registros duplicados, tratamento de valores ausentes, padronização de formatos e validação das informações. Por fim, outro processo transforma os dados da Silver em conjuntos de dados na camada Gold, aplicando regras de negócio, agregações e modelagens para disponibilizar informações prontas para consumo por relatórios, dashboards, aplicações de Business Intelligence (BI), Machine Learning e Inteligência Artificial.
Talvez você esteja se perguntando: qual é a vantagem desse modelo em relação a um Data Warehouse tradicional? À primeira vista, ele pode até parecer menos eficiente em termos de armazenamento, já que os dados são mantidos em diferentes níveis de refinamento. Isso significa que o espaço ocupado pelas camadas Bronze, Silver e Gold pode ser maior do que o volume original de dados. Além disso, é comum que a camada Gold contenha diversas tabelas Delta diferentes, cada uma preparada para atender às necessidades específicas de diferentes áreas da empresa, como financeiro, vendas, marketing ou logística.
A grande vantagem dessa arquitetura está no fato de que essas camadas normalmente são armazenadas em serviços de armazenamento de objetos na nuvem, como Amazon S3, Azure Data Lake Storage, Google Cloud Storage ou Microsoft OneLake, cujo custo por gigabyte é bastante baixo quando comparado ao armazenamento de bancos de dados tradicionais. Dessa forma, o pequeno aumento no espaço utilizado é compensado pelos benefícios obtidos, como maior governança, rastreabilidade, facilidade de reprocessamento, escalabilidade e disponibilidade de dados prontos para diferentes tipos de análises.
Onde o Lakehouse e o Formato Delta são usados na prática?
- Empresas de grande volume de dados que antes precisavam manter um Data Lake e um Data Warehouse separados, com processos custosos de cópia de dados entre os dois ambientes.
- Times de dados que trabalham com streaming, como e-commerces monitorando pedidos em tempo real ou empresas de mídia acompanhando eventos de usuários ao vivo.
- Projetos de Machine Learning, que se beneficiam de acessar dados brutos e históricos completos, algo que Data Warehouses tradicionais nem sempre suportam bem.
- Ambientes com múltiplos times acessando os mesmos dados simultaneamente, onde a garantia de consistência (ACID) evita conflitos e inconsistências.
Ferramentas como Databricks, Apache Spark e serviços de nuvem (Azure Synapse, AWS Glue, entre outros) já têm suporte nativo ou integração direta com o formato Delta, o que ajudou a consolidá-lo como um padrão de mercado — inclusive com iniciativas de padronização aberta, como o Delta Lake Project, hoje parte da Linux Foundation.
Uma das grandes vantagens do formato Delta é que ele não está restrito a plataformas em nuvem ou soluções comerciais. Com bibliotecas de código aberto, como a deltalake para Python, é possível criar e consultar tabelas Delta diretamente em um servidor local ou até mesmo em um notebook de desenvolvimento, aproveitando recursos como controle de versões e alta eficiência no armazenamento dos dados.
Conclusão
Assim como qualquer decisão de arquitetura, depende do contexto. Empresas pequenas, com volume de dados baixo e necessidades simples, muitas vezes não precisam da complexidade de um Lakehouse completo. Mas para organizações que lidam com grandes volumes de dados, múltiplas fontes, streaming e necessidade de governança forte, o Lakehouse — especialmente com o Formato Delta — tem se tornado uma escolha cada vez mais natural, por eliminar a duplicação de esforços entre Data Lake e Data Warehouse tradicionais.
Comentários (0)
Seja o primeiro a comentar.