Engenharia de Dados: O que é, Ferramentas, Processos e Aplicações no Mundo Moderno
 Rael Rodrigues
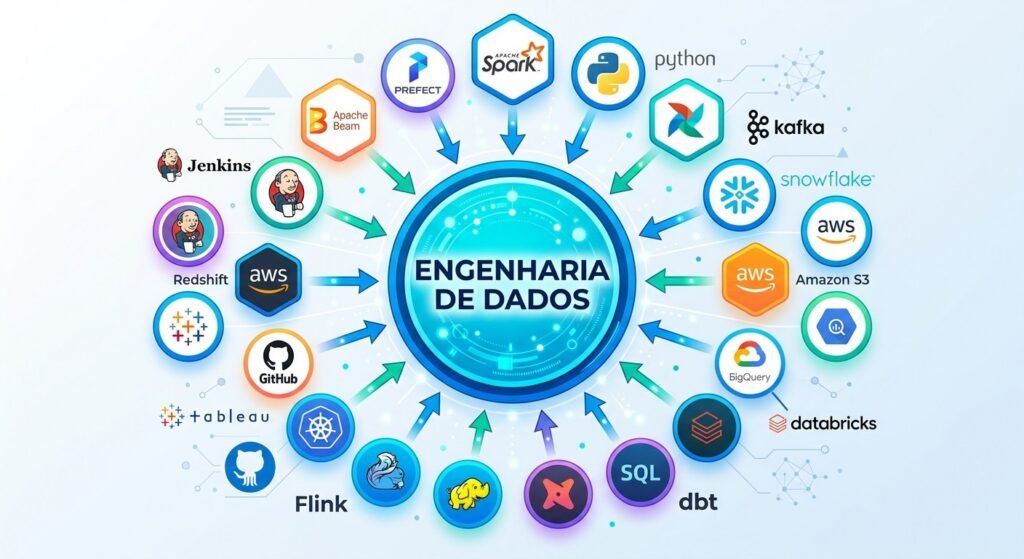
Todos os dias, empresas como Google, Netflix, Amazon e bancos processam bilhões de registros. Mas antes que essas informações possam gerar dashboards, previsões ou sistemas de Inteligência Artificial, existe uma infraestrutura responsável por coletar, organizar e disponibilizar esses dados. Essa infraestrutura é construída pela Engenharia de Dados, uma das áreas mais estratégicas da tecnologia moderna.
O Engenheiro de Dados
A disciplina pode ser definida como o conjunto de técnicas, processos e tecnologias utilizadas para construir e manter a infraestrutura necessária para o tratamento de dados. O objetivo é garantir que dados brutos, provenientes de diferentes fontes, sejam transformados em informações organizadas e acessíveis para análises, relatórios e aplicações de inteligência artificial.
O profissional responsável por essas atividades é conhecido como Engenheiro de Dados (Data Engineer). Sua função vai além do simples armazenamento de informações. Ele projeta arquiteturas escaláveis, desenvolve pipelines de dados, automatiza processos de integração e garante que informações confiáveis estejam disponíveis para cientistas de dados, analistas de dados, profissionais de Business Intelligence, aplicações de Inteligência Artificial e demais sistemas corporativos.
Em um cenário empresarial moderno, os dados são gerados por diversas fontes, como aplicações web, sistemas ERP, CRMs, sensores IoT, dispositivos móveis, APIs externas e bancos de dados transacionais. A Engenharia de Dados atua integrando todas essas fontes em uma estrutura organizada que permita extrair valor dos dados.
Pipeline de Dados
Uma das principais responsabilidades da área é a criação de pipelines de dados. Um pipeline é um fluxo automatizado que captura informações de uma origem, aplica transformações necessárias e entrega os dados processados em um destino final. Esse destino pode ser um Data Warehouse, Data Lake, banco analítico ou ferramenta de Business Intelligence (BI).
ETL
Outro conceito fundamental é o processo conhecido como ETL (Extract, Transform, Load). A ideia é a seguinte, os dados são extraídos das fontes de origem, transformados conforme regras de negócio e, posteriormente, carregados em um ambiente de armazenamento. O ETL foi durante muitos anos o padrão utilizado para integração de dados corporativos.
Arquiteturas Modernas
Com o crescimento das plataformas de Big Data e da computação em nuvem, surgiu também o conceito de ELT (Extract, Load, Transform). Diferentemente do ETL, nesse modelo os dados são inicialmente extraídos das fontes de origem e carregados em seu formato bruto no ambiente de armazenamento. Somente após esse carregamento as transformações são realizadas, aproveitando o alto poder de processamento de plataformas modernas como Snowflake, Databricks, BigQuery e Microsoft Fabric. Essa abordagem oferece maior flexibilidade, preserva os dados originais e facilita a criação de diferentes camadas de processamento para atender às necessidades de diversos usuários e aplicações.
Uma das arquiteturas mais utilizadas para implementar o modelo ELT é a Arquitetura Medallion. Nessa abordagem, os dados percorrem diferentes camadas de refinamento até se tornarem prontos para consumo analítico. A primeira camada, conhecida como Bronze, armazena os dados exatamente como foram recebidos das fontes de origem, preservando todas as informações para auditoria e reprocessamentos futuros. Em seguida, os dados passam para a camada Silver, onde são limpos, padronizados, enriquecidos e validados, eliminando inconsistências e preparando-os para análises mais confiáveis. Por fim, os dados chegam à camada Gold, composta por conjuntos de dados altamente refinados, agregados e organizados para atender dashboards, relatórios, aplicações de Business Intelligence (BI), Machine Learning e Inteligência Artificial.
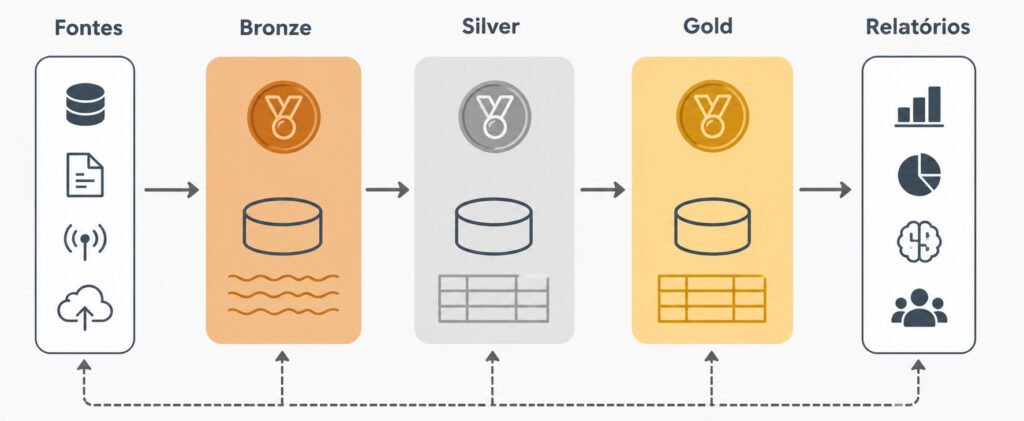
Essa separação em camadas melhora a governança dos dados, facilita a manutenção dos pipelines, reduz retrabalho e permite que diferentes equipes consumam informações adequadas ao seu nível de necessidade. Por esses motivos, a Arquitetura Medallion tornou-se um dos padrões mais adotados em projetos modernos de Engenharia de Dados.
A Arquitetura Medallion é amplamente utilizada em plataformas Lakehouse, como Databricks e Microsoft Fabric.
Em vez de armazenar grandes volumes de dados em arquivos CSV, arquiteturas modernas utilizam formatos colunar como Apache Parquet, que oferecem compressão e leitura muito mais eficientes. Sobre esses formatos surgiram tecnologias como Delta Lake, Apache Iceberg e Apache Hudi, que adicionam recursos como versionamento, transações ACID e evolução de esquemas.
Leia também
Governança de Dados
A Engenharia de Dados também é responsável pela governança e qualidade dos dados. Dados inconsistentes, duplicados ou incompletos podem comprometer análises estratégicas. Por isso, mecanismos de validação, monitoramento e auditoria são implementados para garantir a confiabilidade das informações.
Além da qualidade dos dados, a governança envolve aspectos como segurança, catálogo de dados, rastreabilidade (Data Lineage), controle de acesso e conformidade com legislações como a LGPD.
Bancos de Dados
Entre as principais ferramentas utilizadas pelos engenheiros de dados estão os sistemas de gerenciamento de bancos de dados. Bancos relacionais como PostgreSQL, SQL Server, Oracle e MySQL continuam extremamente relevantes para aplicações corporativas. Além deles, bancos NoSQL como MongoDB, Cassandra e DynamoDB são amplamente utilizados para cargas de trabalho específicas.
No contexto de Big Data, uma das tecnologias mais conhecidas é o Apache Hadoop, que revolucionou a capacidade de armazenamento e processamento distribuído de grandes volumes de dados. Embora novas soluções tenham surgido, o Hadoop ainda influenciou profundamente a arquitetura moderna de dados.
Big Data
Outra ferramenta amplamente utilizada é o Apache Spark, uma plataforma de processamento distribuído capaz de analisar enormes conjuntos de dados com alto desempenho. O Spark tornou-se uma tecnologia central em muitas arquiteturas modernas por sua velocidade e flexibilidade.
A orquestração de pipelines é frequentemente realizada com ferramentas como Apache Airflow, Prefect e Dagster. Essas soluções permitem agendar, monitorar e controlar fluxos complexos de processamento de dados, reduzindo falhas operacionais e aumentando a automação.
Na área de integração de dados, destacam-se ferramentas como Apache Kafka, Apache NiFi e Azure Event Hubs. Essas plataformas possibilitam a transmissão e processamento de dados em tempo real, sendo fundamentais para aplicações que exigem baixa latência.
Computação em Nuvem
Com a popularização da computação em nuvem, serviços especializados passaram a desempenhar papel central na Engenharia de Dados. Na Microsoft Azure, por exemplo, encontram-se soluções como Azure Data Factory, Azure Synapse Analytics, Azure Databricks e Microsoft Fabric. Já na AWS existem serviços como Glue, Redshift e EMR. No Google Cloud destacam-se BigQuery, Dataflow e Dataproc.
Os ambientes de armazenamento também evoluíram significativamente. Atualmente, é comum encontrar arquiteturas baseadas em Data Lakes, que armazenam dados em seu formato bruto, e Data Warehouses, que armazenam dados estruturados para análises. Mais recentemente, surgiu o conceito de Lakehouse, que combina características de ambos os modelos.
Atualmente, grande parte dos novos projetos de Engenharia de Dados é desenvolvida diretamente em plataformas de nuvem devido à elasticidade, alta disponibilidade e escalabilidade praticamente ilimitada desses ambientes.
Áreas de Atuação
A Engenharia de Dados possui papel essencial em projetos de Inteligência Artificial e Machine Learning. Modelos de IA dependem diretamente da qualidade e disponibilidade dos dados utilizados para treinamento. Sem uma infraestrutura de dados sólida, mesmo os algoritmos mais avançados apresentam resultados pouco confiáveis.
No setor financeiro, a Engenharia de Dados é utilizada para análise de transações, detecção de fraudes, avaliação de crédito e monitoramento de riscos. Milhões de registros precisam ser processados continuamente para permitir decisões rápidas e precisas.
No comércio eletrônico, os dados são empregados para personalização de ofertas, recomendação de produtos, análise de comportamento do consumidor e previsão de demanda. Grandes varejistas dependem de pipelines robustos para processar informações geradas a cada clique realizado pelos usuários.
Na indústria, sensores conectados em máquinas e equipamentos produzem uma enorme quantidade de informações. A Engenharia de Dados possibilita a implementação de manutenção preditiva, monitoramento operacional e otimização de processos produtivos por meio da análise contínua desses dados.
No setor de saúde, hospitais e clínicas utilizam plataformas de dados para integrar informações de prontuários, exames laboratoriais, equipamentos médicos e sistemas administrativos. Isso contribui para diagnósticos mais rápidos e para uma gestão mais eficiente dos recursos.
O crescimento da Inteligência Artificial Generativa ampliou ainda mais a importância da Engenharia de Dados. Grandes Modelos de Linguagem (LLMs), sistemas RAG (Retrieval-Augmented Generation) e agentes inteligentes dependem de pipelines capazes de coletar, organizar e disponibilizar informações atualizadas para que os modelos produzam respostas precisas e confiáveis.
Conclusão
Em um cenário onde organizações geram bilhões de registros diariamente, a Engenharia de Dados tornou-se uma disciplina indispensável para transformar dados brutos em informações estratégicas. Ela fornece toda a infraestrutura necessária para integrar, processar, armazenar e disponibilizar dados de forma segura, escalável e confiável.
Além de sustentar projetos de Business Intelligence, Analytics e Machine Learning, a Engenharia de Dados também desempenha papel fundamental na evolução da Inteligência Artificial Generativa, das arquiteturas Lakehouse e das plataformas modernas de computação em nuvem. À medida que as empresas se tornam cada vez mais orientadas por dados, cresce também a demanda por profissionais capazes de construir pipelines eficientes, arquiteturas escaláveis e ambientes de dados preparados para os desafios do futuro.
Comentários (0)
Seja o primeiro a comentar.