Como o SQL é usado na análise de dados profissional
 Rael Rodrigues
No dia a dia de quem trabalha com dados, é raro encontrar alguém que use só uma ferramenta. O mais comum é uma combinação: um pouco de SQL aqui, uma planilha ali, um notebook em Python para o modelo, um dashboard em Power BI para apresentar o resultado. Este artigo foca em uma peça específica dessa engrenagem — o SQL — e explica, na prática, os dois papéis em que ele mais aparece no trabalho de um analista profissional: como ferramenta de investigação rápida (a chamada análise ad-hoc) e como camada de pré-tratamento de dados antes que eles cheguem a ferramentas como Python, Power BI ou Tableau.
O SQL não substitui Python nem as ferramentas de BI
Vale deixar isso claro logo de início, o SQL não compete com Python nem com plataformas de BI. Ele resolve um problema diferente. Python é excelente para modelagem estatística, machine learning e análises que exigem lógica de programação mais elaborada. Ferramentas de BI como Power BI, Tableau e Looker Studio são construídas para transformar dados já organizados em painéis visuais que qualquer pessoa do negócio consegue interpretar sem escrever uma linha de código. O SQL, por sua vez, atua numa camada anterior a essas duas: ele é a linguagem que fala diretamente com o banco de dados onde as informações moram, seja um sistema de vendas, um cadastro de clientes ou uma base de eventos de um aplicativo.
Por isso, em times de dados maduros, o SQL raramente aparece como a etapa final de uma análise. Ele aparece antes — preparando o terreno para que Python ou o BI façam o que fazem de melhor.
Análise ad-hoc: a pergunta rápida que não precisa de um dashboard
Um dos usos mais comuns do SQL no trabalho profissional é responder perguntas pontuais que surgem no meio do dia — o que os times de dados costumam chamar de análise ad-hoc. Alguém do time de marketing quer saber quantos clientes fizeram uma segunda compra no último trimestre; o time financeiro quer entender por que a receita de uma categoria específica caiu na semana passada; o gerente de produto quer confirmar se uma funcionalidade nova está sendo usada por um grupo específico de usuários. Nenhuma dessas perguntas justifica construir um dashboard novo ou escrever um script em Python — elas pedem uma resposta rápida, geralmente entregue em minutos.
É exatamente nesse cenário que o SQL se destaca. Como a linguagem foi pensada para se aproximar do raciocínio humano, um analista consegue escrever uma consulta que filtra, agrupa e cruza tabelas quase na velocidade em que a pergunta é formulada, direto na fonte dos dados, sem precisar exportar nada para outro programa, frases como “selecione o valor da tabela de vendas onde a categoria for eletrônicos entre as data x e y” praticamente se traduzem palavra por palavra para um comando SQL real. É esse tipo de agilidade que torna o SQL indispensável mesmo em empresas que já têm um Power BI robusto ou um time de cientistas de dados trabalhando em Python: para a pergunta rápida do dia a dia, ir direto ao banco de dados com uma consulta continua sendo o caminho mais curto entre a dúvida e a resposta, principalmente quando é necessário confirmar uma informação que está sendo contestada em um relatório de BI ou quando essa informação não existe no relatório.
Imagine que são 9 horas da manhã e o gerente comercial envia uma mensagem: “As vendas de notebooks caíram quase 20% na última semana. Você consegue verificar o que aconteceu?”
Em vez de abrir o Power BI ou criar um script em Python, o analista normalmente acessa o banco de dados e começa uma investigação usando SQL. Em poucos minutos ele consegue comparar períodos, identificar quais produtos venderam menos, verificar se houve queda em uma região específica ou descobrir se algum item ficou sem estoque.
Pré-tratamento: o trabalho que acontece antes do Python e do BI
O segundo papel do SQL é menos visível, mas talvez ainda mais importante: preparar os dados antes que eles cheguem a outra ferramenta. Bancos de dados relacionais costumam guardar as informações espalhadas em várias tabelas, otimizadas para o funcionamento do sistema que as gerou — e não para facilitar a vida de quem quer analisá-las depois. Antes de qualquer gráfico ou modelo, alguém precisa juntar essas tabelas, filtrar o que não interessa, corrigir duplicidades e resumir os dados em um formato limpo.
É esse trabalho de organização que o SQL faz com muito mais eficiência do que Python rodando na memória do computador ou uma planilha tentando abrir milhões de linhas. Quando um analista escreve uma consulta que junta a tabela de vendas com a de clientes, filtra apenas o período desejado e já calcula totais por categoria, ele está entregando para a etapa seguinte — seja um notebook Python, seja um painel de BI — uma base muito mais enxuta e pronta para uso, em vez de forçar essas ferramentas a lidar com o volume bruto e a bagunça dos dados originais.
Na prática, esse é o motivo pelo qual analistas que usam Python quase sempre começam o script conectando a um banco e rodando uma consulta SQL para trazer só os dados necessários, em vez de carregar tabelas inteiras para depois filtrar dentro do próprio Python. E é também o motivo pelo qual, quando você conecta o Power BI ou o Tableau diretamente a um banco de dados, a ferramenta está por trás dos panos gerando e executando consultas SQL para buscar exatamente as informações que aparecem no seu gráfico — mesmo que o analista nunca escreva uma linha de código ali dentro.
Os comandos que realmente fazem o trabalho pesado
Na prática, quase toda análise em SQL gira em torno de um punhado de ideias centrais, usadas em conjunto conforme a pergunta que se quer responder.
Tudo começa com o comando SELECT, que define quais colunas você quer ver, combinado com WHERE, que filtra as linhas que interessam — por exemplo, apenas vendas acima de um determinado valor, ou clientes de uma cidade específica. É o par mais básico e também o mais usado no dia a dia, porque a maioria das perguntas de negócio começa como um recorte: “quero ver só isso, dentro dessas condições”.
Quando a pergunta envolve resumir informações — total de vendas por categoria, média de gasto por cliente, número de pedidos por mês — entra o GROUP BY, quase sempre acompanhado de funções como SUM, AVG, COUNT ou MAX. É esse conjunto que transforma centenas de milhares de linhas individuais em poucas linhas de resumo, prontas para virar um gráfico ou uma tabela dinâmica.
Para cruzar informações que estão espalhadas em tabelas diferentes — como uma tabela de vendas e outra de clientes — existe o JOIN. Ele funciona como uma ponte: diz ao banco de dados para juntar as duas tabelas usando uma coluna em comum, como o identificador do cliente, permitindo trazer o nome, a cidade ou qualquer outra informação do cliente para dentro da análise de vendas.
Quando a análise já resumida por GROUP BY ainda precisa de um filtro adicional — por exemplo, mostrar apenas as categorias que ultrapassaram uma certa receita total — usa-se o HAVING, que age como um WHERE que funciona depois do agrupamento.
Para organizar os resultados de forma legível, o ORDER BY ordena as linhas pela coluna que fizer mais sentido, do maior para o menor valor ou em ordem alfabética. E quando a análise envolve tempo — evolução mensal de receita, comparação entre trimestres — funções de data como DATE_TRUNC ou EXTRACT permitem agrupar registros por dia, mês ou ano, essenciais para qualquer análise de tendência.
Por fim, para análises um pouco mais sofisticadas, existem as chamadas funções de janela, como RANK e ROW_NUMBER, que permitem criar rankings sem perder o detalhe de cada linha original, e o WITH, que cria uma espécie de tabela temporária dentro da própria consulta, útil para organizar análises em etapas e deixar consultas complexas muito mais fáceis de ler e revisar depois.
Muita gente imagina que SQL é uma linguagem de programação complexa, mas ela foi criada justamente para permitir que consultas sejam escritas de forma próxima ao inglês. Depois de aprender alguns comandos como SELECT, WHERE, GROUP BY e JOIN, já é possível responder boa parte das perguntas do dia a dia de um analista.
O SQL não trabalha sobre arquivos CSV nem planilhas. Ele consulta bancos de dados relacionais como PostgreSQL, MySQL, SQL Server, Oracle e SQLite. É justamente por executar as consultas dentro do próprio banco que ele consegue lidar com milhões de registros de forma muito mais eficiente do que carregar todos os dados na memória de um computador.
O que você consegue fazer usando apenas SQL
Esses são só alguns exemplos.
- descobrir os produtos mais vendidos;
- calcular faturamento mensal;
- identificar clientes que mais compram;
- comparar vendas entre anos;
- encontrar produtos sem estoque;
- calcular ticket médio;
- detectar vendas duplicadas;
- construir conjuntos de dados para dashboards;
- preparar dados para Machine Learning.
Vamos para alguns exemplos de script SQL
Imagine que você precisa responder a seguinte pergunta para seu chefe: Quais produtos estão vendendo menos que a média dos demais?
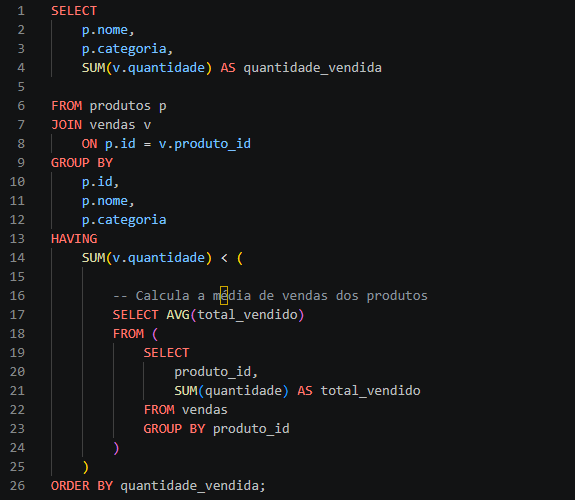
Aqui o SQL resolve um problema em duas etapas. Primeiro ele calcula quanto cada produto vendeu. Depois executa uma segunda consulta, escondida dentro da primeira (uma subconsulta), para descobrir a média de vendas de todos os produtos. Por fim, compara cada produto com essa média e retorna apenas aqueles que tiveram desempenho inferior. Perceba que estamos fazendo uma comparação estatística simples diretamente no banco de dados, sem precisar exportar os dados para Python.
Próximo exemplo: Quais clientes costumavam comprar produtos da categoria Informática, mas nos últimos três meses compraram apenas produtos da categoria Móveis?
Esse tipo de resposta dificilmente já estará disponível em um dashboard. É uma investigação específica.
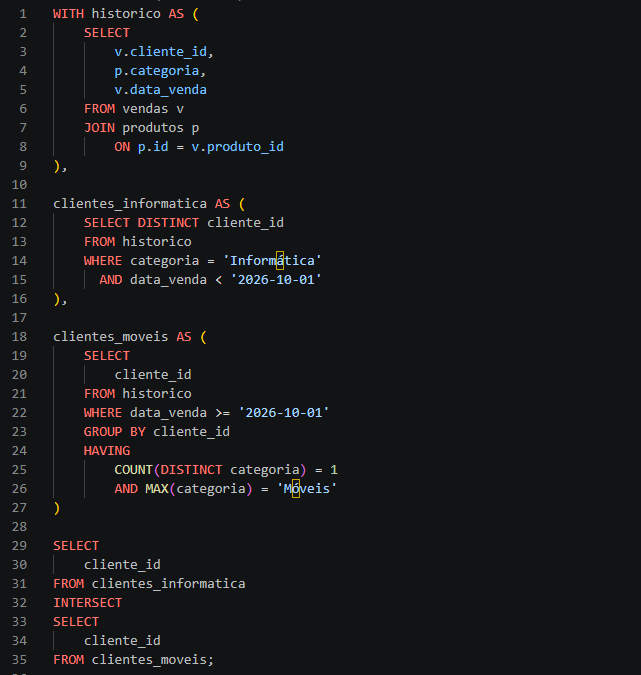
Essa consulta identifica uma mudança de comportamento.
A consulta foi dividida em etapas usando a cláusula WITH, tornando o código mais organizado e fácil de entender. Primeiro, é criado um histórico contendo o cliente, a categoria do produto comprado e a data da compra. Em seguida, são identificados os clientes que compraram produtos da categoria Informática antes da data de referência. Depois, são selecionados os clientes que, nos últimos três meses, compraram exclusivamente produtos da categoria Móveis. Por fim, o operador INTERSECT encontra a interseção entre esses dois grupos, retornando apenas os clientes que atendem às duas condições.
Mais um exemplo de script para uma consulta ad-hoc: Quais pares de produtos aparecem com maior frequência na mesma venda?
Essa é uma análise que ajuda a responder perguntas como: Quem compra notebook também costuma comprar mouse? ou: Vale a pena colocar esses produtos próximos no local de vendas?
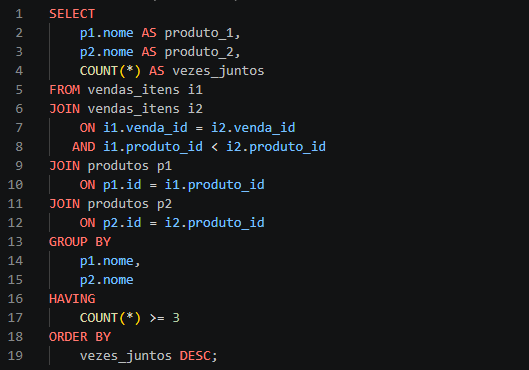
Essa consulta procura identificar pares de produtos que costumam ser comprados juntos. Para isso, a tabela vendas_itens é relacionada com ela mesma por meio do identificador da venda (venda_id), permitindo comparar todos os produtos pertencentes à mesma compra. A condição i1.produto_id < i2.produto_id evita que o mesmo par seja contado duas vezes e também impede que um produto seja comparado consigo mesmo. Em seguida, a consulta conta quantas vezes cada combinação de produtos aparece nas vendas, mantém apenas os pares que ocorreram pelo menos três vezes (HAVING COUNT(*) >= 3) e ordena o resultado pelos pares mais frequentes.
Recursos do SQL que ajudam a responder perguntas de negócio
Vou deixar aqui uma lista com recursos do SQL para análises ad-hoc que podem ajudar a solucionar problemas de negócios.
| Recurso SQL | Para que serve | Exemplo de uso |
|---|---|---|
SELECT | Escolher quais colunas serão retornadas | Mostrar nome e preço dos produtos |
WHERE | Filtrar apenas os registros desejados | Vendas acima de R$ 1.000 |
ORDER BY | Ordenar os resultados | Produtos mais vendidos primeiro |
GROUP BY | Agrupar registros para criar resumos | Faturamento por categoria |
HAVING | Filtrar resultados após um agrupamento | Categorias com mais de 100 vendas |
JOIN | Combinar informações de várias tabelas | Relacionar vendas e produtos |
LEFT JOIN | Encontrar registros sem correspondência | Produtos que nunca foram vendidos |
COUNT() | Contar registros | Quantidade de pedidos realizados |
SUM() | Somar valores | Receita total por mês |
AVG() | Calcular médias | Ticket médio por cliente |
MIN() / MAX() | Encontrar menor ou maior valor | Produto mais caro |
DISTINCT | Remover valores duplicados | Clientes únicos que compraram |
CASE | Criar regras condicionais | Classificar clientes por faixa de gasto |
IN | Comparar com uma lista de valores | Vendas de lojas específicas |
BETWEEN | Filtrar intervalos | Compras entre duas datas |
LIKE | Buscar textos por padrão | Clientes cujo nome começa com “A” |
EXISTS | Verificar existência de registros relacionados | Clientes que já realizaram compras |
UNION | Unir resultados de consultas diferentes | Consolidar vendas de duas bases |
INTERSECT | Encontrar registros comuns entre consultas | Clientes presentes em dois grupos |
WITH (CTE) | Dividir consultas complexas em etapas | Organizar uma análise em múltiplas fases |
| Subconsultas | Utilizar o resultado de uma consulta dentro de outra | Comparar um produto com a média de vendas |
ROW_NUMBER() | Numerar registros | Top 10 clientes |
RANK() | Criar rankings | Ranking de vendedores por faturamento |
DENSE_RANK() | Ranking sem pular posições | Ranking por categoria |
LAG() | Comparar com o registro anterior | Comparar vendas com o mês anterior |
LEAD() | Comparar com o próximo registro | Analisar evolução temporal |
OVER() | Executar funções de janela | Acumulados, médias móveis e rankings |
Embora o SQL possua dezenas de recursos, alguns se destacam na resolução de análises ad-hoc mais elaboradas. O JOIN permite combinar informações espalhadas em diferentes tabelas, as subconsultas possibilitam comparar dados com médias ou totais calculados dinamicamente, o WITH (CTE) organiza consultas longas em etapas mais legíveis, enquanto as funções de janela, como ROW_NUMBER(), RANK() e LAG(), tornam possível criar rankings, comparar períodos e calcular indicadores sem perder o detalhe dos registros originais.
O lugar do SQL na caixa de ferramentas
No fim das contas, a análise de dados profissional raramente depende de escolher entre SQL, Python e ferramentas de BI — depende de saber onde cada um entra. O SQL cuida da ponta mais próxima da fonte: responde perguntas rápidas direto no banco de dados e prepara, limpa e resume as informações antes que elas sigam para uma análise mais elaborada em Python ou para um dashboard interativo. Dominar bem essa etapa costuma tornar todo o resto do trabalho — o script em Python, o painel no Power BI — mais rápido e muito mais confiável, porque parte de dados que já chegaram organizados.
Ferramentas mudam. Frameworks aparecem e desaparecem. Mas, há mais de quatro décadas, o SQL continua sendo a principal linguagem para consultar dados armazenados em bancos relacionais. Independentemente de você seguir carreira como analista de dados, engenheiro de dados, cientista de dados ou desenvolvedor, aprender SQL significa aprender a conversar diretamente com a principal fonte de informação das empresas: seus bancos de dados.
Quer se aprofundar em SQL?
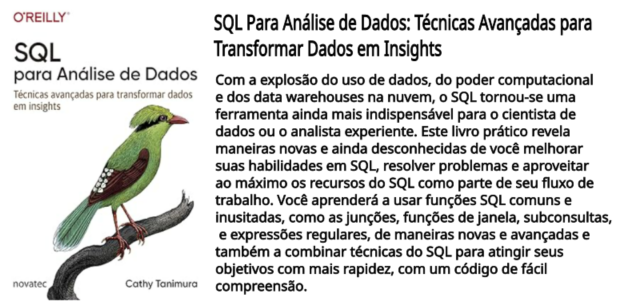
Se você gostou deste artigo e deseja aprender SQL aplicado à análise de dados, este livro é uma excelente leitura para iniciantes e profissionais que desejam evoluir na carreira.
Este artigo contém links de afiliado. Se você comprar através deles, podemos receber uma pequena comissão, sem custo extra pra você.
Comentários (0)
Seja o primeiro a comentar.