Bancos NoSQL: origem, funcionamento e uso profissional
 Rael Rodrigues
O que é NoSQL
NoSQL significa “Not Only SQL” — não apenas SQL. É o nome dado a uma família de sistemas de gerenciamento de banco de dados que não seguem o modelo relacional clássico (tabelas, linhas, colunas e chaves estrangeiras). Em vez disso, cada tipo de banco NoSQL armazena dados de um jeito diferente, pensado para resolver problemas específicos de escala e flexibilidade que o modelo relacional tradicional tinha dificuldade em resolver.
Os bancos NoSQL surgiram para atender às demandas de aplicações distribuídas e grandes volumes de dados que se tornaram comuns com o crescimento da internet. Em vez de substituir os bancos relacionais, eles ampliaram as possibilidades de modelagem e armazenamento de dados, evoluindo ao longo dos anos em famílias especializadas — de bancos de documentos a bancos vetoriais voltados para inteligência artificial, como será detalhado adiante.
Origem: por que e quando surgiu
O termo “NoSQL” foi cunhado em 1998 por Carlo Strozzi, para nomear um banco de dados relacional open-source que, por opção de design, simplesmente não usava SQL como linguagem de consulta. Não tem relação direta com o movimento que conhecemos hoje.
O uso moderno do termo nasceu em 2009, quando Eric Evans e Johan Oskarsson organizaram um encontro em São Francisco para discutir bancos de dados distribuídos e não relacionais que estavam surgindo em empresas como Google e Amazon. Esse encontro popularizou “NoSQL” como está sendo usado até hoje.
Quem “criou” o NoSQL não foi uma pessoa ou empresa única. Foi um movimento coletivo da indústria, motivado por publicações técnicas de grandes empresas de internet:
- Google publicou em 2003 o artigo do Google File System e em 2006 o do Bigtable, mostrando como armazenar e processar dados em escala massiva usando clusters de máquinas comuns.
- Amazon publicou em 2007 o artigo do Dynamo, um banco de dados distribuído chave-valor criado para garantir que o carrinho de compras da Amazon nunca ficasse indisponível, mesmo com falhas de servidores.
Esses dois papers são considerados a base teórica de quase todo o ecossistema NoSQL atual — deles nasceram diretamente ou por inspiração o Cassandra, o HBase, o DynamoDB, o MongoDB, entre outros.
Por que foi criado
No início dos anos 2000, empresas como Google, Amazon, Facebook e Twitter enfrentavam um problema que os bancos relacionais tradicionais (Oracle, MySQL, SQL Server) não resolviam bem:
- Volume: bilhões de registros, impossíveis de caber em um único servidor.
- Velocidade de escrita: milhões de operações por segundo, exigindo distribuição entre muitas máquinas.
- Dados variados e sem estrutura fixa: posts de redes sociais, logs, sensores IoT, cliques — dados que mudam de formato com frequência e não se encaixam bem em tabelas rígidas.
- Escalar bancos relacionais era caro e difícil: a saída tradicional era “escalar verticalmente” (comprar uma máquina maior e mais cara). O NoSQL propôs “escalar horizontalmente” (adicionar mais máquinas comuns e baratas ao cluster).
Em resumo: o NoSQL nasceu para resolver problemas de escala web, não porque o SQL estivesse “errado” — é uma ferramenta para um contexto diferente.
| Característica | SQL (Relacional) | NoSQL |
| Estrutura | Tabelas com linhas e colunas | Documentos, chave-valor, grafos, famílias de colunas |
| Esquema | Rígido (schema definido) | Flexível (schema pode variar) |
| Relacionamentos | JOINs entre tabelas | Embedding, referências ou grafos |
| Escalabilidade | Principalmente vertical | Principalmente horizontal |
| Transações | ACID | Alguns oferecem ACID (depende do banco) |
| Consultas | SQL | Linguagem própria (MQL, CQL, Cypher, comandos Redis…) |
| Melhor para | Sistemas transacionais (ERP, financeiro, CRM) | Big Data, microsserviços, cache, IA, IoT |
| Exemplos | PostgreSQL, MySQL, SQL Server, Oracle | MongoDB, Redis, Cassandra, Neo4j, DynamoDB |
Onde os bancos NoSQL rodam
Bancos NoSQL rodam essencialmente em qualquer lugar onde se roda software de servidor:
- On-premises, em servidores próprios da empresa ou datacenters privados.
- Na nuvem, como serviços gerenciados — é aqui que a maior parte do uso profissional acontece hoje: Amazon DynamoDB, MongoDB Atlas, Google Cloud Firestore/Bigtable, Azure Cosmos DB, Redis Cloud.
- Em contêineres, via Docker e Kubernetes, muito comum em arquiteturas de microsserviços.
- Em dispositivos de borda (edge), versões leves como o Redis ou SQLite-like embarcadas em aplicações mobile ou IoT.
Um diferencial importante é que muitos bancos NoSQL foram projetados com suporte nativo a arquiteturas distribuídas, permitindo particionamento (sharding) e replicação entre diferentes nós, o que os torna naturalmente compatíveis com infraestrutura em nuvem elástica.
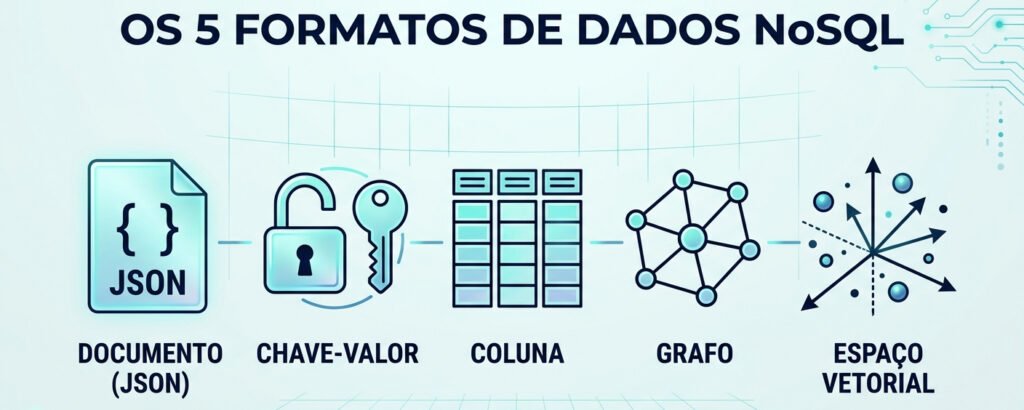
Os principais modelos de bancos NoSQL
Não existe “um” banco NoSQL — existem famílias diferentes, cada uma com um modelo de dados próprio:
1. Chave-valor (Key-Value) — armazena pares simples de chave e valor, como um dicionário gigante. Extremamente rápido para leitura/escrita. Exemplos: Redis, Amazon DynamoDB, Riak.
2. Documentos (Document) — armazena registros como documentos semiestruturados, geralmente em JSON ou BSON, sem exigir um esquema fixo. Exemplos: MongoDB, Couchbase, Firestore.
3. Colunar (Wide Column / famílias de colunas) — armazena dados organizados em famílias de colunas, otimizado para grandes volumes e leituras/escritas em escala, muito usado em séries temporais e big data. Exemplos: Apache Cassandra, HBase, Google Bigtable.
4. Grafos (Graph) — armazena dados como nós e relacionamentos (arestas), ideal para modelar conexões complexas: redes sociais, recomendação, detecção de fraude. Exemplos: Neo4j, Amazon Neptune, ArangoDB.
5. Vetorial (Vector) — categoria mais recente — com a explosão da IA generativa, surgiu uma quinta categoria relevante: bancos especializados em armazenar embeddings vetoriais para busca semântica, RAG (retrieval-augmented generation) e memória de agentes de IA. Exemplos: Pinecone, Weaviate, Milvus (e extensões como pgvector, que trazem essa capacidade para bancos SQL).
Dá para usar SQL clássico para consultar?
Depende do banco, mas via de regra não — e esse é justamente um dos pontos que definem o NoSQL. Cada família usa sua própria linguagem ou API de consulta:
- MongoDB usa uma linguagem de consulta baseada em documentos JSON (Mongo Query Language), não SQL.
- Cassandra usa o CQL (Cassandra Query Language), que tem sintaxe parecida com SQL (SELECT, INSERT, WHERE), mas não suporta joins nem as mesmas garantias transacionais do SQL puro — é inspirado no SQL, mas não é SQL.
- Redis usa comandos próprios (GET, SET, HGET, etc.), sem sintaxe declarativa parecida com SQL.
- Neo4j usa o Cypher, uma linguagem declarativa própria para consultas de grafo.
- Vários bancos NoSQL hoje oferecem camadas de compatibilidade SQL para facilitar a adoção — por exemplo, o Cosmos DB da Azure tem uma API SQL para consultar documentos, e ferramentas como Presto/Trino permitem rodar consultas SQL “por cima” de várias fontes NoSQL. Mas isso é uma camada de tradução, não o motor nativo do banco.
Na prática: quem programa em NoSQL aprende a linguagem específica daquele banco. O ganho de flexibilidade e escalabilidade vem da adoção de modelos de dados e mecanismos de distribuição diferentes dos bancos relacionais tradicionais. Dependendo do banco e do caso de uso, isso pode proporcionar vantagens de desempenho, disponibilidade ou escalabilidade.
Exemplos de consultas em diferentes bancos NoSQL
Para deixar mais concreta a diferença entre as linguagens de consulta, vale ver como a mesma ideia — buscar um usuário e algumas informações relacionadas a ele — se traduz em cada modelo.
MongoDB (documentos)
As consultas são feitas com métodos que recebem objetos JSON como filtro, não comandos textuais. Para buscar todos os usuários ativos de São Paulo, ordenados por nome:
db.usuarios.find(
         { cidade: "São Paulo", ativo: true }
).sort({ nome: 1 })
Para atualizar um campo dentro de um documento sem reescrever o documento inteiro:
db.usuarios.updateOne(
          { _id: "u123" },
          { $set: { "endereco.cep": "01310-100" } }
)
Repare que não existe JOIN nativo como no SQL — se for preciso combinar dados de duas coleções, usa-se o operador $lookup dentro de um pipeline de agregação, algo mais próximo de uma composição de etapas do que de uma junção relacional clássica.
Cassandra (colunar) — CQL
O CQL é propositalmente parecido com SQL, o que facilita a curva de aprendizado, mas com restrições importantes: normalmente é preciso filtrar pela chave de partição, e não existem joins.
SELECT nome, email FROM usuarios WHERE cidade = 'São Paulo';Se cidade não for parte da chave de partição ou de um índice secundário, essa consulta simplesmente falha — no Cassandra, o modelo de dados é desenhado em função das consultas que a aplicação vai fazer, e não o contrário, como se costuma fazer em SQL.
Redis (chave-valor)
Não existe uma linguagem declarativa; são comandos diretos sobre estruturas de dados em memória:
SET usuario:u123:nome "Ana Silva"
GET usuario:u123:nome
HSET usuario:u123 nome "Ana Silva" cidade "São Paulo"
HGETALL usuario:u123
O primeiro grupo trata cada usuário como uma chave simples; o segundo usa um hash, uma estrutura que permite guardar vários campos sob uma mesma chave, algo mais próximo de um “registro”.
Neo4j (grafos) — Cypher
A sintaxe do Cypher é visual, pensada para representar nós e relacionamentos com uma notação parecida com um desenho de setas:
MATCH (u:Usuario {cidade: "São Paulo"})-[:AMIGO_DE]->(a:Usuario)
RETURN u.nome, a.nome
Essa consulta busca todos os usuários de São Paulo e retorna, para cada um, os nomes de seus amigos diretos — o tipo de consulta que, em SQL puro, exigiria vários joins recursivos e se tornaria rapidamente complexa e lenta à medida que o grau de relacionamento aumenta.
Comparando com SQL
A mesma busca de “usuários de São Paulo e seus amigos” em um banco relacional clássico exigiria algo como:
SELECT u.nome, a.nome
FROM usuarios u
JOIN amizades f ON u.id = f.usuario_id
JOIN usuarios a ON f.amigo_id = a.id
WHERE u.cidade = 'São Paulo';
Funciona, mas conforme a profundidade do relacionamento cresce (amigos de amigos de amigos), o número de joins explode e a performance cai — exatamente o tipo de cenário em que um banco de grafos como o Neo4j passa a fazer mais sentido do que insistir no modelo relacional.
Como aprender NoSQL na prática
Um caminho de estudo eficiente:
- Entenda os fundamentos teóricos primeiro: teorema CAP (Consistência, Disponibilidade, Tolerância a Partição), diferença entre consistência forte e eventual, o que é sharding e replicação.
- Escolha um banco de documentos para começar: MongoDB é uma boa porta de entrada, pois possui documentação ampla, uma comunidade grande e uma sintaxe baseada em documentos que costuma ser intuitiva para quem já conhece estruturas como JSON.
- Pratique com um projeto real pequeno: uma API REST simples (Node.js, Python ou Java) conectada ao MongoDB ou ao Redis já ensina os conceitos essenciais na prática.
- Aprenda Redis para entender chave-valor e cache: é leve, rápido de instalar localmente e extremamente usado no mercado como camada de cache.
- Explore um banco colunar e um de grafos para entender os outros modelos (Cassandra e Neo4j têm sandboxes gratuitos online).
- Estude modelagem de dados NoSQL: é uma habilidade diferente da modelagem relacional — em vez de normalizar dados, você geralmente desnormaliza pensando no padrão de acesso da aplicação (“modele para a consulta, não para o dado”).
- Use ambientes gratuitos na nuvem: MongoDB Atlas, DynamoDB (camada gratuita da AWS) e Neo4j AuraDB oferecem planos gratuitos para prática sem precisar montar infraestrutura própria.
- Certificações: MongoDB, AWS (DynamoDB) e Neo4j oferecem certificações reconhecidas no mercado, úteis para currículo.
Uso profissional e onde aparecem nas arquiteturas
O NoSQL hoje não compete com o SQL — convive com ele. A abordagem dominante no mercado em 2026 é a persistência poliglota: usar múltiplos bancos de dados dentro da mesma arquitetura, cada um otimizado para uma tarefa específica, em vez de forçar um único banco a fazer tudo.
Dados da Stack Overflow Developer Survey 2025, que coletou respostas de mais de 26 mil desenvolvedores sobre tecnologias de banco de dados, mostram esse cenário de convivência: o PostgreSQL é o banco de dados mais usado, com 55,6% dos desenvolvedores, seguido pelo MySQL, com 40,5%. Entre as tecnologias NoSQL listadas na pesquisa, o Redis aparece com 28% de uso, seguido pelo MongoDB, com 24%. Esses números ajudam a ilustrar como bancos relacionais e NoSQL continuam sendo utilizados em conjunto nas arquiteturas modernas.
Fonte: Stack Overflow Developer Survey 2025 — seção Technology/Databases
Onde eles aparecem tipicamente, e o que fazem lá:
Cache e sessões de usuário — Redis é amplamente utilizado como camada de cache entre a aplicação e o banco principal, guardando resultados de consultas frequentes, sessões de login e filas de mensagens em memória, reduzindo drasticamente a latência.
Catálogos de produtos e conteúdo dinâmico — MongoDB e bancos de documentos são muito usados em e-commerces e CMSs, onde cada produto ou artigo pode ter atributos diferentes, sem exigir alteração de esquema toda vez que um novo tipo de campo aparece.
Aplicações de altíssima escala e disponibilidade global — Cassandra e DynamoDB aparecem em sistemas que precisam funcionar 24/7 em múltiplas regiões geográficas sem downtime, como sistemas de mensageria, streaming e plataformas de e-commerce como a Amazon.
Redes sociais, recomendação e detecção de fraude — bancos de grafos como Neo4j modelam relações complexas entre pessoas, compras e transações, usados para motores de recomendação, análise de fraude bancária e mapeamento de redes de conexões.
IoT, séries temporais e telemetria — bancos colunares como Cassandra e HBase armazenam grandes volumes de dados de sensores e métricas, organizados por tempo, muito usados em monitoramento industrial e observabilidade de sistemas.
Busca e logs — o Elasticsearch (tecnicamente um motor de busca com características NoSQL) é padrão de mercado para busca textual, análise de logs e observabilidade (a famosa stack ELK: Elasticsearch, Logstash, Kibana).
IA generativa, RAG e agentes de IA — a fronteira mais recente — bancos vetoriais dedicados para armazenar e consultar embeddings usados em busca semântica, RAG e memória de agentes de IA formam um mercado que vem crescendo rapidamente com a expansão de aplicações de IA. Empresas hoje avaliam se usam bancos vetoriais nativos (Pinecone, Weaviate) ou extensões vetoriais dentro de bancos SQL já existentes, como o pgvector do PostgreSQL.
O papel do NoSQL em arquiteturas de microsserviços
Em arquiteturas modernas baseadas em microsserviços, é comum que cada serviço tenha seu próprio banco de dados, escolhido conforme a necessidade específica daquele serviço — um padrão chamado database per service. Nesse cenário:
- O serviço de catálogo usa MongoDB (documentos flexíveis).
- O serviço de carrinho/sessão usa Redis (velocidade).
- O serviço de pedidos e pagamentos usa PostgreSQL (transações ACID robustas).
- O serviço de recomendação usa Neo4j (relacionamentos).
- O serviço de busca usa Elasticsearch.
- O serviço de assistente de IA usa um banco vetorial para dar contexto ao modelo de linguagem.
Essa é a realidade mais comum encontrada em empresas de tecnologia hoje: não existe “o banco vencedor”, existe o banco certo para cada parte do sistema.
Conclusão
O movimento NoSQL moderno ganhou força no fim dos anos 2000, inspirado pelos papers técnicos de Google e Amazon, como resposta prática aos limites de escala dos bancos relacionais diante do crescimento explosivo da internet. Não substituiu o SQL — passou a coexistir com ele, cada um ocupando o espaço em que é mais forte: consistência transacional de um lado, escala e flexibilidade de esquema do outro, com a fronteira mais recente sendo o suporte às aplicações de inteligência artificial.
Para quem trabalha ou deseja ingressar em Ciência de Dados, Engenharia de Dados, Desenvolvimento de Software ou Arquitetura de Sistemas, entender os diferentes modelos de bancos NoSQL — e, principalmente, saber quando cada um se aplica — tornou-se uma habilidade tão relevante quanto dominar o próprio SQL. Mais do que decorar sintaxes específicas, o diferencial está em reconhecer o padrão de acesso aos dados de cada problema e escolher a ferramenta certa para ele.
Comentários (0)
Seja o primeiro a comentar.