Os principais algoritmos de Machine Learning: o que fazem e para que servem
 Rael Rodrigues
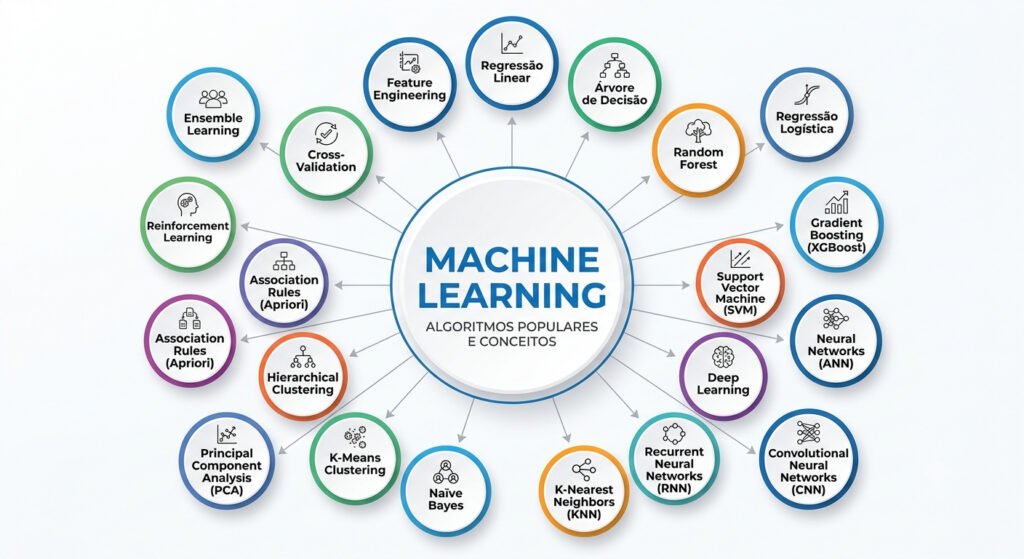
Machine Learning (aprendizado de máquina) é a área que ensina computadores a aprenderem padrões a partir de dados, em vez de seguir regras fixas escritas manualmente. Mas por trás desse conceito existem dezenas de algoritmos diferentes, cada um com pontos fortes, limitações e aplicações específicas. Neste artigo, vamos explicar os principais algoritmos usados no dia a dia de quem trabalha com dados, incluindo dois nomes que aparecem bastante em vagas e projetos mais avançados: XGBoost e SARIMAX.
O que é uma Machine Learning e para que serve?
Machine Learning, ou Aprendizado de Máquinas, é um ramo da Inteligência Artificial focado em algoritmos especiais usados para aprender padrões em dados e conseguir fazer previsões usando dados semelhantes.
Existem algoritmos para várias tarefas diferentes, como por exemplo:
- Prever o faturamento para os próximos meses;
- Prever se um paciente terá uma doença com base em seu histórico medico;
- Segmentar clientes, ou qualquer outra coisa, com base em alguns dados;
- Sugerir filmes para clientes com base no que já assistiu e de acordo com seu perfil;
- Identificar se um e-mail é spam ou não;
- Prever se uma máquina vai falhar com base em dados de monitoramento;
- e muito mais.
O processo para treinar uma machine learning
A primeira coisa que você precisa é ter um objetivo claro em mente onde a machine learning possa te ajudar. Por exemplo, usa-la para diagnósticos médicos.
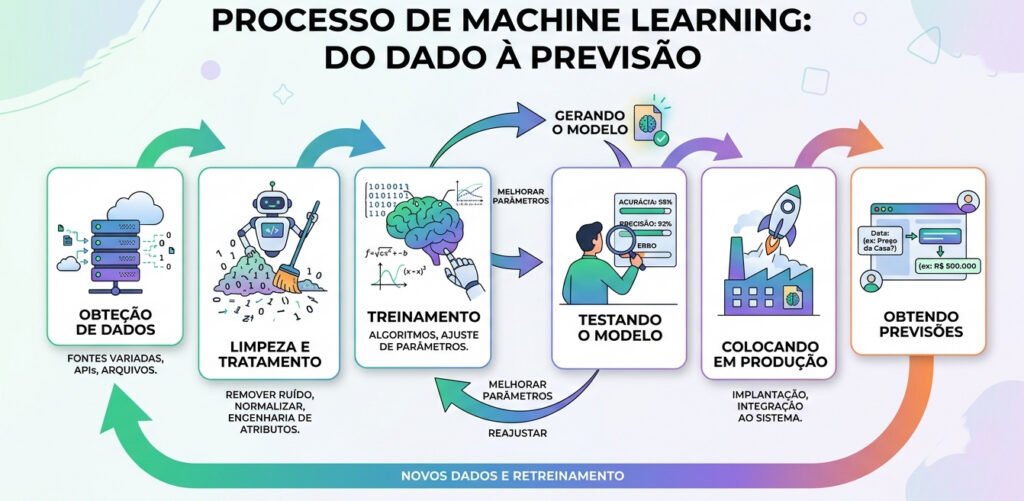
Tudo começa com a obtenção dos dados para treinamento e testes, seguido na maioria das vezes por um tratamento prévio nos dados para remover qualquer coisa que posso atrapalhar o algoritmo.
Após isso, os dados são separados entre dados de treinamento e teste. No primeiro momento, os dados de treinamento serão usados para que o algoritmo possa aprender o padrão, isso gera um modelo, logo após é feito os primeiros testes para verificar se o modelo criado consegue fazer previsões assertivas com os dados de testes e caso não tenha um bom desempenho, o processo de treinamento é feito novamente usando novos parâmetros ou novos dados. Uma vez criado o modelo que tenha bom desempenho, esse modelo é colocado em produção para ser usado para as previsões.
Agora, vamos ver alguns desses algoritmos de Machine Learning.
Leia também
Antes de tudo: os dois grandes tipos de aprendizado
A maioria dos algoritmos de Machine Learning se encaixa em uma dessas categorias:
- Aprendizado supervisionado: o modelo aprende a partir de dados que já têm a resposta certa (rótulo). Exemplo: prever se um cliente vai cancelar o serviço, com base em clientes que já cancelaram ou não no passado.
- Aprendizado não supervisionado: o modelo encontra padrões em dados que não têm resposta pré-definida. Exemplo: agrupar clientes parecidos entre si, sem saber de antemão quais são os grupos.
Com isso em mente, vamos aos algoritmos.
1. Regressão Linear
O que faz: encontra a relação matemática entre uma variável que você quer prever (número) e uma ou mais variáveis explicativas, assumindo que essa relação é aproximadamente uma linha reta.
Para que é usado: previsão de valores numéricos contínuos.
Exemplo de aplicação: prever o preço de um imóvel com base em metragem, número de quartos e localização.
2. Regressão Logística
O que faz: apesar do nome parecido com o anterior, é usada para classificação, não para prever números contínuos. Ela estima a probabilidade de algo pertencer a uma categoria (geralmente sim ou não, 0 ou 1).
Para que é usado: classificação binária (duas categorias).
Exemplo de aplicação: prever se um cliente vai ou não cancelar um serviço (churn), ou se uma transação é fraudulenta ou não.
3. Árvores de Decisão
O que faz: cria uma estrutura em formato de árvore, dividindo os dados em perguntas sucessivas (“o cliente tem mais de 30 anos? Sim/Não, ele gosta de filmes? Sim/Não, etc”) até chegar a uma decisão final.
Para que é usado: classificação e regressão, com a vantagem de ser fácil de interpretar visualmente. A Árvore de Decisão é um tipo de algoritmo que pode ser usada no lugar da Regressão Logística e Linear
Exemplo de aplicação: decidir se um pedido de crédito deve ser aprovado, com base em regras claras de renda, idade e histórico.
4. Random Forest (Floresta Aleatória)
O que faz: em vez de usar uma única árvore de decisão, cria várias árvores diferentes e combina os resultados delas (uma espécie de “votação”), o que reduz erros e overfitting (quando o modelo decora os dados em vez de aprender o padrão real).
Para que é usado: classificação e regressão em geral, sendo uma escolha muito comum por ser robusta e relativamente fácil de usar.
Exemplo de aplicação: prever se um cliente vai comprar um produto com base em seu histórico de navegação e compras anteriores.
5. XGBoost
O que faz: XGBoost significa Extreme Gradient Boosting. Assim como o Random Forest, ele também combina várias árvores de decisão, mas de um jeito diferente: cada nova árvore é construída para corrigir os erros da árvore anterior, de forma sequencial. Isso costuma gerar modelos muito mais precisos.
Para que é usado: classificação e regressão em problemas mais complexos, sendo um dos algoritmos mais usados atualmente em competições de dados (como as do Kaggle) e em ambientes corporativos, por equilibrar bem performance e velocidade. O XGBoost é muito usado no lugar dos algoritmos anteriores.
Exemplo de aplicação: prever a probabilidade de inadimplência de um cliente em um banco, considerando dezenas de variáveis financeiras e comportamentais ao mesmo tempo.
6. K-Means
O que faz: agrupa dados em um número definido de grupos (clusters), com base em semelhanças entre eles, sem que seja necessário informar previamente o que caracteriza cada grupo.
Para que é usado: segmentação de dados, quando você quer descobrir padrões ou grupos naturais dentro de uma base.
Exemplo de aplicação: segmentar clientes de um e-commerce em grupos como “compradores frequentes”, “compradores ocasionais” e “clientes inativos”, para campanhas de marketing mais direcionadas.
7. KNN (K-Nearest Neighbors)
O que faz: classifica um novo dado com base nos dados mais parecidos (vizinhos) que já existem na base, olhando para os “K” exemplos mais próximos dele.
Para que é usado: classificação e regressão simples, especialmente quando os dados têm um padrão de proximidade claro.
Exemplo de aplicação: recomendar produtos parecidos com o que um cliente já comprou, com base na similaridade com outros compradores.
8. SARIMAX
O que faz: SARIMAX é a sigla para Seasonal AutoRegressive Integrated Moving Average with eXogenous factors. Não é exatamente uma machine learning, como os anteriores, na verdade, é um modelo estatístico voltado especificamente para séries temporais — ou seja, dados que variam ao longo do tempo, como vendas mensais ou visitas diárias a um site.
Ele consegue capturar três coisas ao mesmo tempo:
- Tendência: se os valores estão subindo, caindo ou estáveis ao longo do tempo.
- Sazonalidade: padrões que se repetem em intervalos regulares (por exemplo, vendas mais altas todo mês de dezembro).
- Variáveis externas (exógenas): fatores de fora da série que também influenciam o resultado, como uma campanha de marketing ou um feriado.
Para que é usado: previsão de séries temporais, principalmente quando existe sazonalidade e/ou influência de fatores externos conhecidos.
Exemplo de aplicação: prever a demanda de vendas de uma loja para os próximos meses, levando em conta a sazonalidade de datas comemorativas, o impacto de campanhas promocionais planejadas, finais de semana, feriados, dias com promoção forte, etc.
9. Redes Neurais (introdução)
O que faz: inspiradas (de forma simplificada) no funcionamento do cérebro humano, as redes neurais processam dados por meio de camadas de “neurônios” artificiais, ajustando pesos internos até conseguir identificar padrões complexos.
Para que é usado: problemas mais complexos, como reconhecimento de imagens, processamento de linguagem natural e previsões com grandes volumes de dados não estruturados.
Exemplo de aplicação: reconhecimento facial em aplicativos de segurança, ou chatbots que entendem linguagem natural.
Como escolher o algoritmo certo?
Não existe um algoritmo “melhor” de forma absoluta — a escolha depende de:
- O tipo de problema: você quer prever um número, uma categoria, ou encontrar grupos escondidos nos dados?
- O tipo de dado: é uma série temporal? São dados tabulares? Imagens? Texto?
- A necessidade de interpretação: às vezes é mais importante entender por que o modelo tomou uma decisão do que ter a maior precisão possível — nesses casos, uma Árvore de Decisão simples pode ser preferível a um XGBoost complexo.
- Volume de dados disponível: alguns algoritmos, como redes neurais, costumam precisar de muito mais dados para funcionar bem.
Na prática, é comum que times de dados testem mais de um algoritmo para o mesmo problema, comparando o desempenho de cada um antes de decidir qual usar em produção.
Você quer conhecer com detalhes alguns algoritmos de machine learning? da uma olhada nos links abaixo:
Comentários (0)
Seja o primeiro a comentar.