Ambientes Virtuais em Python: venv, Conda
 Rael Rodrigues
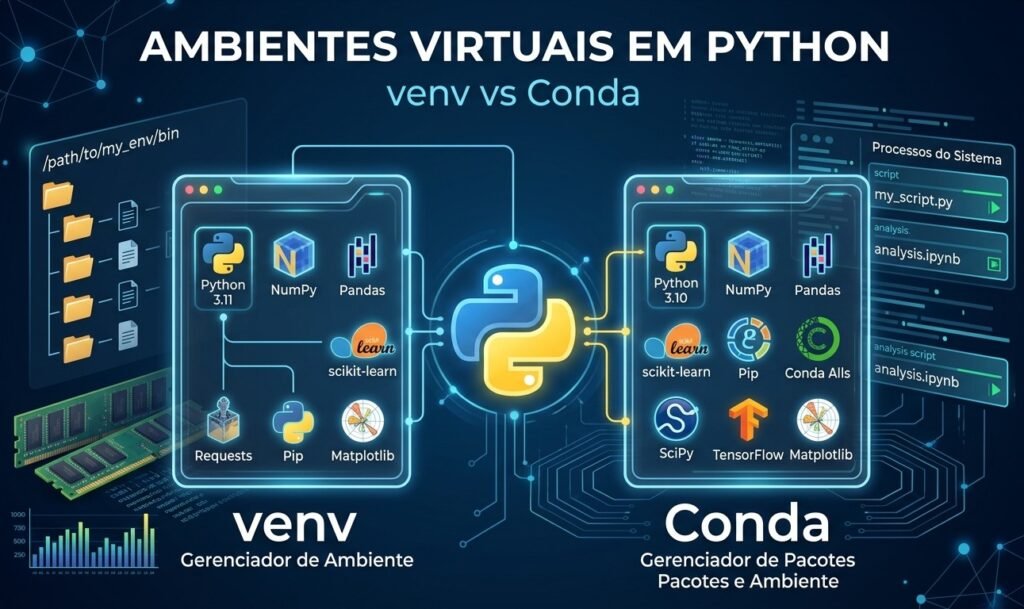
Se você trabalha com Python ou ciência de dados, provavelmente já viveu essa cena: um notebook que funcionava perfeitamente há seis meses de repente começa a quebrar, uma biblioteca não é mais compatível com outra, ou pior, você instala uma versão nova do pandas para um projeto e, sem perceber, quebra o pipeline de outro projeto que dependia de uma versão antiga. Esse tipo de conflito de dependências é extremamente comum quando todos os projetos compartilham a mesma instalação global do Python e das suas bibliotecas.
É exatamente esse problema que os ambientes virtuais em Python resolvem. Eles permitem isolar as dependências de cada projeto, garantindo que cada análise, modelo ou pipeline de dados rode com as versões exatas de bibliotecas para as quais foi desenvolvido — sem interferir nas dependências de outros projetos e reduzindo o risco de alterações indesejadas no ambiente principal do sistema. Neste artigo, vamos explorar duas das ferramentas mais usadas para isso, venv e Conda.
O problema que os ambientes virtuais em Python resolvem
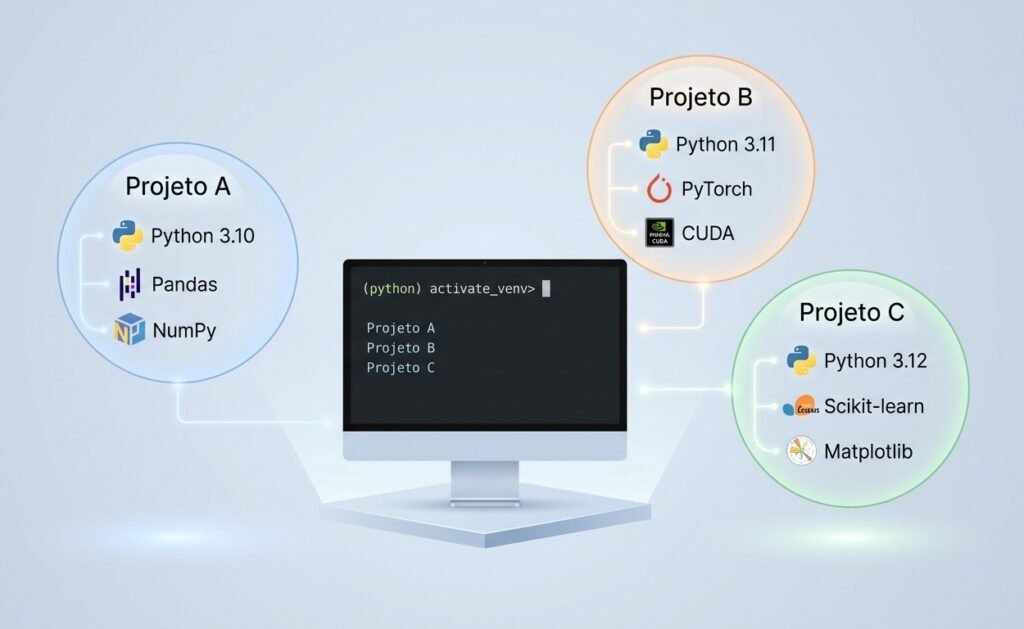
Em ciência de dados, é comum trabalhar em vários projetos ao mesmo tempo: um modelo de previsão de vendas que usa scikit-learn 1.2, um projeto de visão computacional que exige uma versão específica do PyTorch, e uma análise exploratória que depende de uma versão recente do pandas com funcionalidades que quebram compatibilidade com código legado. Se tudo isso estiver instalado no mesmo ambiente Python global, cedo ou tarde as versões vão colidir.
Além do conflito de versões, há a questão da reprodutibilidade — um dos pilares mais importantes (e mais negligenciados) da ciência de dados. Um modelo treinado hoje precisa poder ser retreinado daqui a um ano, por outra pessoa, em outra máquina, com resultados tão próximos quanto possível, dentro das condições definidas pelo projeto. Isso só é possível se as dependências exatas (incluindo versões de bibliotecas numéricas, que às vezes alteram resultados de cálculos de ponto flutuante) estiverem documentadas e isoladas.
O que é venv: a solução nativa do Python para isolamento de dependências
O venv é um módulo que já vem embutido no Python (a partir da versão 3.3) e cria um ambiente isolado usando apenas os recursos da biblioteca padrão. Ele é leve, rápido de criar e não exige instalação de nenhuma ferramenta externa.
Na prática, o fluxo de uso é simples:
python -m venv meu_projeto_env
source meu_projeto_env/bin/activate  # Linux/Mac
meu_projeto_env\Scripts\activate     # Windows

# instalando as bibliotecas
pip install pandas scikit-learn matplotlib
O venv cria uma estrutura própria para o ambiente, que inclui um interpretador Python associado ao ambiente e uma pasta site-packages própria, separada da instalação global. Isso significa que quando você instala uma biblioteca dentro desse ambiente ativado, ela vai parar apenas ali, sem afetar o restante do sistema.
Para ciência de dados, o venv funciona bem em cenários mais simples, principalmente quando o projeto depende só de pacotes Python puros, instaláveis via pip. O ponto de atenção aparece quando entram bibliotecas com dependências binárias complexas ou que exigem componentes específicos do sistema operacional. Nesses cenários, o Conda pode simplificar bastante a instalação e o gerenciamento dessas dependências.
Leia também
O que é Conda: gerenciador de ambientes pensado para dados científicos
O Conda é um gerenciador de ambientes e pacotes com uma proposta mais ampla que a do venv: ele pode gerenciar pacotes e dependências que não são exclusivamente Python, incluindo bibliotecas binárias e componentes utilizados por aplicações científicas. — coisas como versões específicas de BLAS/LAPACK (usadas por NumPy), CUDA (para uso de GPU em deep learning), ou compiladores C/Fortran que muitas bibliotecas científicas exigem por trás dos panos.
Criar um ambiente com Conda segue uma lógica parecida:
conda create --name meu_projeto_env python=3.11
conda activate meu_projeto_env

# instalando as bibliotecas
conda install pandas scikit-learn numpy matplotlib
A grande vantagem aqui é que o Conda resolve toda a árvore de dependências binárias de uma vez, incluindo versões compiladas otimizadas para o seu sistema operacional e arquitetura de processador. Isso é particularmente valioso em bibliotecas como NumPy, SciPy, TensorFlow ou PyTorch, que dependem de bibliotecas e componentes nativos. Em determinados cenários, especialmente quando há combinações complexas de versões e dependências, o gerenciamento desses componentes via Conda pode simplificar bastante a configuração.
Além disso, distribuições como o Anaconda e o Miniconda já vêm com um conjunto grande de bibliotecas voltadas para ciência de dados pré-configuradas e testadas para funcionar em conjunto, o que economiza tempo de configuração no início de um projeto.
venv ou Conda: qual escolher em um projeto de ciência de dados?
Não existe uma resposta universal, mas alguns critérios ajudam na decisão. Se o seu projeto usa majoritariamente bibliotecas Python puras e você já tem um ambiente de sistema razoavelmente estável (por exemplo, em um servidor Linux já configurado com as bibliotecas de sistema necessárias), o venv tende a ser suficiente e mais leve. Já quando o projeto envolve bibliotecas científicas pesadas, uso de GPU, ou você trabalha em um time com máquinas heterogêneas (Windows, Mac, Linux) e precisa que todos tenham ambientes numéricos consistentes, o Conda costuma economizar muito tempo de configuração e evitar problemas sutis de compatibilidade binária.
Vale mencionar também o mamba, um substituto do Conda que resolve dependências muito mais rápido, e o micromamba, uma versão ainda mais leve — ambos cada vez mais populares em times de dados que sentem o Conda tradicional lento para resolver ambientes complexos.
E o Docker, não seria uma alternativa?
É comum, ao pesquisar sobre isolamento de ambientes em Python, esbarrar também no Docker. Vale um esclarecimento rápido: o Docker resolve um problema parecido, mas em outro nível. Enquanto o venv e o Conda isolam principalmente o interpretador Python e suas dependências dentro do sistema operacional, o Docker empacota a aplicação junto com suas bibliotecas e dependências de sistema em um contêiner. Isso proporciona um nível maior de isolamento e facilita a execução do mesmo ambiente em diferentes máquinas e infraestruturas, seja o notebook do cientista de dados, um servidor de produção ou uma infraestrutura de nuvem. É uma solução poderosa, especialmente quando o objetivo é levar um modelo para produção.
Dito isso, o foco deste artigo é o venv e o Conda, que são as ferramentas do dia a dia para quem trabalha explorando dados, treinando modelos e rodando notebooks — o Docker fica para um próximo artigo, com a atenção que merece.
Aplicações práticas no dia a dia da ciência de dados
Um cenário muito comum é o versionamento de ambientes junto ao código. Ao lado de um notebook ou script de análise, é boa prática manter um arquivo requirements.txt (no caso do venv/pip) ou environment.yml (no caso do Conda) descrevendo exatamente quais bibliotecas e versões foram usadas. Isso permite que qualquer colega, ou você mesmo no futuro, recrie o ambiente exato com um único comando:
pip install -r requirements.txt
# ou
conda env create -f environment.yml
Outro uso frequente é isolar ambientes por etapa do pipeline de dados. É comum ter um ambiente para pré-processamento e engenharia de features, outro para treinamento de modelos de deep learning (com uma versão específica de CUDA e PyTorch), e outro ainda para servir o modelo em produção. Cada um desses ambientes pode ter conjuntos de bibliotecas completamente diferentes, e mantê-los isolados evita que uma atualização em um quebre os outros.
Ambientes virtuais também são essenciais ao trabalhar com Jupyter. É possível registrar um ambiente virtual como um “kernel” específico do Jupyter, permitindo alternar entre diferentes ambientes (e portanto diferentes conjuntos de bibliotecas) dentro do mesmo notebook server, sem precisar reinstalar nada:
pip install ipykernel
python -m ipykernel install --user --name=meu_projeto_env
O que acontece na memória e no sistema ao usar um ambiente virtual em python
Um ponto pouco discutido, mas importante para entender de verdade o que um ambiente virtual em python faz, é o que acontece nos bastidores, tanto no disco quanto na memória durante a execução.
Quando você cria um ambiente virtual (seja venv ou Conda), o que acontece fisicamente é a criação de uma nova estrutura de diretórios contendo um interpretador Python próprio e uma pasta de pacotes isolada (site-packages). Isso não duplica o Python inteiro na memória do sistema operacional em repouso — é apenas uma estrutura de arquivos no disco. A “mágica” acontece nas variáveis de ambiente: quando você ativa um ambiente, o script de ativação modifica temporariamente variáveis como PATH e VIRTUAL_ENV, fazendo com que o comando python aponte para o interpretador daquele ambiente, fazendo com que o sistema operacional procure o executável python e os pacotes primeiro dentro da pasta do ambiente virtual, e não nas instalações globais.
Isso tem uma implicação direta no processo em tempo de execução: quando você roda um script ou notebook, o processo do Python é carregado na memória RAM apontando para os módulos daquele ambiente específico. Se dois ambientes diferentes têm versões diferentes do NumPy, por exemplo, e você rodar dois processos Python simultâneos — um em cada ambiente — cada processo possui seu próprio espaço de endereçamento virtual e carrega as bibliotecas correspondentes ao ambiente utilizado. Embora os processos sejam isolados logicamente, o sistema operacional pode compartilhar determinadas páginas físicas de memória quando isso é possível e seguro.
Isso significa também que ambientes virtuais não trazem, por si só, nenhum ganho ou perda de desempenho em tempo de execução — a diferença de velocidade entre bibliotecas isoladas vem exclusivamente das versões e implementações escolhidas (por exemplo, uma versão do NumPy compilada com uma biblioteca BLAS otimizada rodará mais rápido do que uma versão genérica, independentemente de estar num ambiente virtual ou não). O que o ambiente virtual garante é apenas que o interpretador carregue os módulos corretos na memória a partir do caminho isolado correspondente, evitando que uma versão errada de uma biblioteca seja importada por engano.
No caso específico do Conda, existe uma camada extra: além de gerenciar pacotes Python, ele também pode fornecer e gerenciar bibliotecas nativas e outras dependências binárias dentro do ambiente. Isso significa que o ambiente Conda pode disponibilizar essas dependências binárias junto aos demais pacotes do ambiente e configurar os caminhos necessários para que sejam encontradas durante a execução, reduzindo conflitos entre versões.
Isso é uma diferença importante em relação ao venv, que não gerencia essas dependências nativas como parte do próprio ambiente.
O que acontece quando você deleta um ambiente virtual
Um ambiente virtual pode ser removido de forma simples — no caso do venv, basta apagar a pasta do ambiente (rm -rf meu_projeto_env, por exemplo); no Conda, existe um comando dedicado (conda env remove --name meu_projeto_env) que também limpa os registros internos do gerenciador. Mas vale entender o que isso realmente significa em termos práticos.
Se você deletar a pasta de um ambiente virtual enquanto um processo Python daquele ambiente ainda está em execução, o comportamento depende do sistema operacional. No Linux e no Mac, o sistema de arquivos usa contagem de referências: enquanto o processo mantiver os arquivos abertos (o interpretador e as bibliotecas já carregadas na memória), o conteúdo continua acessível para aquele processo específico, mesmo que o caminho tenha sido removido do disco — os dados só são de fato liberados quando o último processo que os usa é encerrado. Já no Windows, o comportamento costuma ser mais restritivo: o sistema operacional pode bloquear a exclusão de arquivos que estão em uso, gerando um erro de “arquivo em uso” até que o processo seja finalizado. Em ambos os casos, uma vez que o script ou notebook é encerrado, o processo perde toda referência aos módulos daquele ambiente e a memória RAM associada é liberada normalmente pelo sistema operacional — não sobra nenhum resíduo do ambiente na memória.
Depois que o ambiente é apagado e nenhum processo mais o utiliza, o efeito prático é que o interpretador, os pacotes e os metadados daquele ambiente deixam de existir — não é possível reativá-lo, nem reaproveitar o histórico de instalações. Se você tentar rodar um script que dependia daquele ambiente (por exemplo, um kernel do Jupyter registrado anteriormente), vai receber um erro de que o executável Python não foi encontrado no caminho esperado. É por isso que manter um requirements.txt ou environment.yml versionado é tão importante: eles são exatamente o que permite recriar o ambiente do zero rapidamente, caso ele seja apagado por engano, corrompido, ou simplesmente perdido ao trocar de máquina.
Vale destacar também que deletar um ambiente virtual nunca afeta os dados dos seus projetos (datasets, notebooks, modelos salvos em disco), já que esses arquivos normalmente vivem fora da pasta do ambiente. O que se perde é apenas a configuração de bibliotecas — e é justamente por isso que separar código e dados da configuração de dependências é uma boa prática de organização em projetos de ciência de dados.
Conclusão
Ambientes virtuais deixaram de ser um detalhe técnico opcional para se tornarem uma prática essencial em ciência de dados. Eles garantem reprodutibilidade — um requisito cada vez mais cobrado em projetos sérios de dados e pesquisa —, evitam conflitos silenciosos entre bibliotecas de diferentes projetos, e permitem organizar o trabalho de forma muito mais limpa, com cada projeto vivendo em seu próprio espaço isolado.
O venv é uma ótima escolha para quem quer simplicidade e trabalha majoritariamente com pacotes Python puros. O Conda, por sua vez, se destaca em projetos de ciência de dados que dependem de bibliotecas numéricas pesadas, GPU e compatibilidade binária entre sistemas operacionais diferentes. Entender como cada um funciona por dentro — inclusive como eles manipulam variáveis de ambiente e isolam módulos na memória durante a execução — ajuda não só a escolher a ferramenta certa, mas também a depurar problemas com mais confiança quando algo sai do esperado.
No fim das contas, adotar ambientes virtuais é um investimento pequeno de tempo que evita grandes dores de cabeça no futuro — e é um dos hábitos mais simples que separam um projeto de dados amador de um projeto profissional, reprodutível e confiável.
Comentários (0)
Seja o primeiro a comentar.