Apache Spark: como funciona, arquitetura e por que ainda importa
 Rael Rodrigues
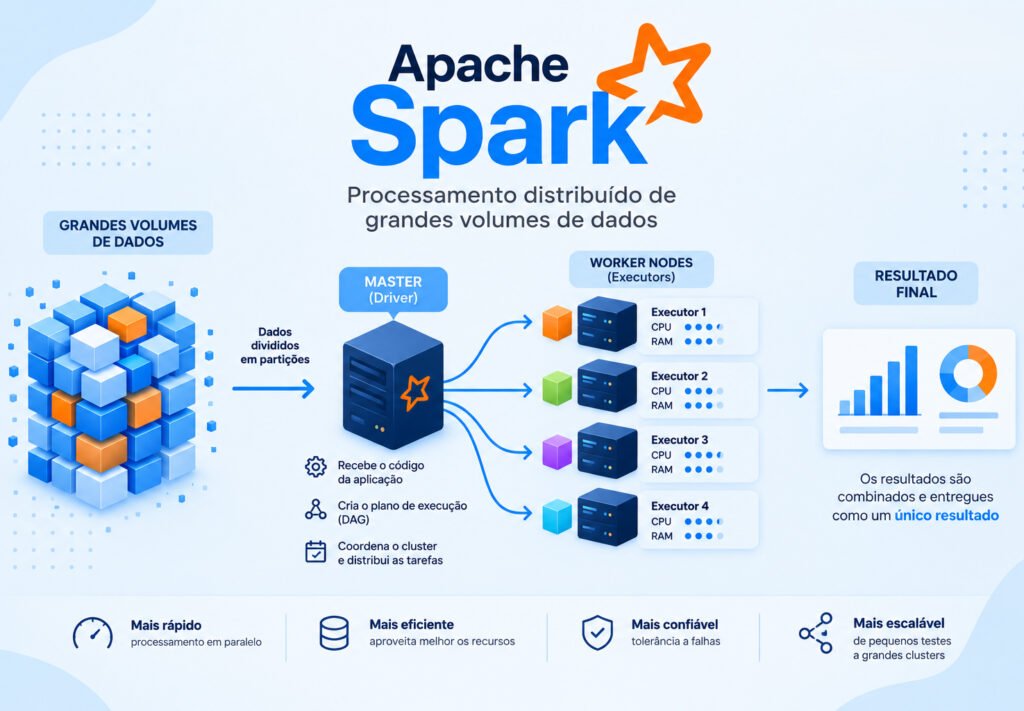
Todos os dias, empresas geram quantidades gigantescas de dados: transações bancárias, cliques em sites, sensores de máquinas, registros de aplicativos. Processar tudo isso em um único computador seria inviável, tanto pelo tempo que levaria quanto pela quantidade de memória e processamento necessários. É exatamente esse problema que o Apache Spark resolve. Ele é um sistema que permite dividir o processamento de grandes volumes de dados entre vários computadores trabalhando juntos, de forma coordenada, e devolver o resultado como se tivesse sido feito em uma máquina só. Neste artigo, vamos entender de onde ele veio, como funciona por dentro, onde roda, quais conceitos são essenciais para trabalhar com ele e um exemplo prático de uso.
Quem criou e por quê
O Spark nasceu em 2009 no AMPLab, um laboratório de pesquisa da Universidade da Califórnia, Berkeley, sob liderança de Matei Zaharia. Na época, a ferramenta mais usada para processar big data era o Hadoop MapReduce. O problema do MapReduce era que, a cada etapa de um processamento, ele salvava os resultados parciais no disco rígido antes de seguir para a próxima etapa. Isso é seguro, mas lento — e ficava especialmente ruim em tarefas que precisam repetir cálculos várias vezes sobre os mesmos dados, como é comum em machine learning.
A grande diferença do Spark em relação ao modelo tradicional do Hadoop MapReduce foi sua capacidade de manter dados em memória para reutilizá-los entre diferentes etapas do processamento, reduzindo a necessidade de gravar e ler continuamente resultados intermediários no disco. Essa característica é especialmente importante em tarefas que precisam executar várias operações sobre os mesmos dados, como análises iterativas e algoritmos de machine learning. Embora o Spark também possa utilizar o disco quando necessário, o uso da memória RAM permite reduzir significativamente a quantidade de operações de entrada e saída e, em determinadas situações, proporcionar ganhos expressivos de desempenho em relação ao processamento baseado no MapReduce.
Em 2013 o projeto foi doado para a Apache Software Foundation, entidade sem fins lucrativos que cuida de vários projetos de código aberto, e em 2014 os próprios criadores fundaram a Databricks, empresa que até hoje é a principal responsável por manter e evoluir o Spark comercialmente.
Conceitos que é preciso conhecer
Antes de entender a arquitetura, vale conhecer algumas ideias centrais que aparecem o tempo todo quando se fala de Spark.
O primeiro é a ideia de dados distribuídos. Em vez de um arquivo gigante ficar guardado inteiro em um só lugar, o Spark quebra esse arquivo em pedaços menores e espalha esses pedaços entre várias máquinas. Cada máquina processa só a parte que recebeu, e no final os resultados são juntados.
O segundo conceito é o de processamento paralelo: como os dados estão divididos entre várias máquinas, o processamento também acontece ao mesmo tempo em todas elas, em vez de uma tarefa esperar a outra terminar. É isso que faz o Spark ser rápido em tarefas grandes.
Outro conceito importante é a tolerância a falhas. Quando se trabalha com dezenas ou centenas de máquinas, é normal que alguma falhe no meio do processo. O Spark foi desenhado para lidar com isso: ele sabe recriar a parte perdida do processamento sem precisar recomeçar tudo do zero, porque guarda um registro de como cada pedaço de dado foi criado.
Também é essencial entender a diferença entre transformações e ações. No Spark, quando você pede para filtrar dados, somar valores ou juntar tabelas, ele não executa isso imediatamente — ele apenas anota mentalmente o que precisa ser feito. Isso é uma transformação. O processamento de fato só acontece quando você pede um resultado final, como salvar o arquivo ou exibir uma contagem — isso é uma ação. Esse comportamento é chamado de avaliação preguiçosa (lazy evaluation), e existe porque permite ao Spark olhar para todas as etapas pedidas de uma vez e encontrar a forma mais eficiente de executá-las, em vez de fazer cada passo isoladamente.
Por fim, existe o conceito de partições: são os pedaços em que os dados são divididos para serem espalhados entre as máquinas. Quantas mais partições bem distribuídas, melhor o paralelismo — e um dos ajustes finos mais comuns ao trabalhar com Spark é justamente decidir como particionar os dados da melhor forma.
Como os dados transitam pelo Spark
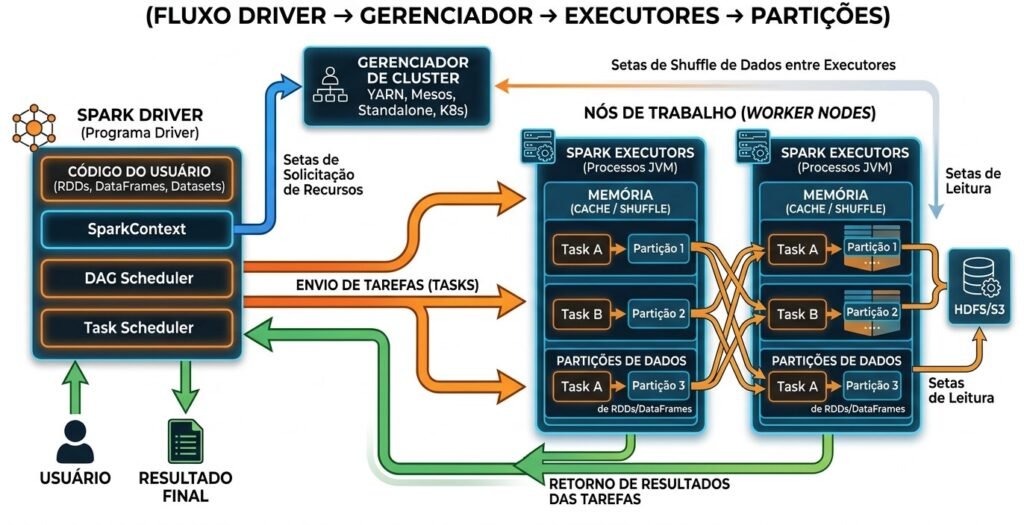
Para visualizar o caminho que os dados percorrem, imagine uma aplicação que precisa ler um arquivo enorme de vendas, calcular o total vendido por região e salvar o resultado.
Tudo começa no driver, o processo que roda o programa principal escrito pelo desenvolvedor. É o driver quem lê as instruções do código, entende o que precisa ser feito e monta um plano de execução — como se fosse um mapa de tarefas.
Esse plano de execução pode ser representado por um DAG (Directed Acyclic Graph), ou grafo acíclico direcionado. Ele descreve as operações que precisam ser realizadas e a relação entre elas, permitindo que o Spark organize a melhor forma de executar o processamento. Por exemplo, uma aplicação pode primeiro ler os dados, depois filtrá-los, agrupá-los e finalmente calcular uma soma. O Spark utiliza essa sequência para planejar a execução e transformar as operações em tarefas que serão distribuídas entre os executores.
Esse plano é enviado para o gerenciador de cluster, um componente responsável por saber quais máquinas estão disponíveis no conjunto de computadores (o cluster) e por distribuir trabalho entre elas. Ele pode ser o próprio gerenciador do Spark, ou ferramentas externas como YARN e Kubernetes, que também são usadas para gerenciar outros tipos de aplicação além do Spark.
Com as máquinas disponíveis identificadas, entram em cena os executores: processos que rodam em cada máquina do cluster e são responsáveis por processar de fato os dados. O arquivo de vendas do nosso exemplo é dividido em partições, e cada executor recebe uma ou mais partições para trabalhar. Um executor pode estar somando as vendas da região Sul, enquanto outro soma as da região Nordeste, tudo ao mesmo tempo.
Conforme cada executor termina sua parte, os resultados parciais são combinados — nesse caso, juntando os totais de cada região — e o resultado final volta para o driver, que então salva o arquivo de saída ou exibe o resultado. Se algum executor falhar no meio do caminho, o Spark identifica que aquela partição não foi processada e manda refazer só aquele pedaço em outra máquina disponível, sem precisar recomeçar o processamento inteiro.
Internamente, o driver organiza todo esse trabalho em três níveis. Quando uma ação é chamada — como o show() do exemplo mais adiante neste artigo — o driver cria um job, que representa aquela solicitação de processamento como um todo. Esse job é então quebrado em stages, que são blocos de etapas que podem ser executadas em sequência sem precisar reorganizar os dados entre as máquinas; normalmente um novo stage começa toda vez que é preciso agrupar ou cruzar dados que estão espalhados em partições diferentes, como acontece em um groupBy. Por fim, cada stage é dividido em tasks, que são a menor unidade de trabalho do Spark: cada task normalmente é responsável pelo processamento de uma partição de dados e é enviada a um executor específico. Ou seja, um job vira vários stages, e cada stage vira várias tasks — uma para cada partição —, o que explica por que o número de partições influencia diretamente quanto trabalho é distribuído entre as máquinas disponíveis.
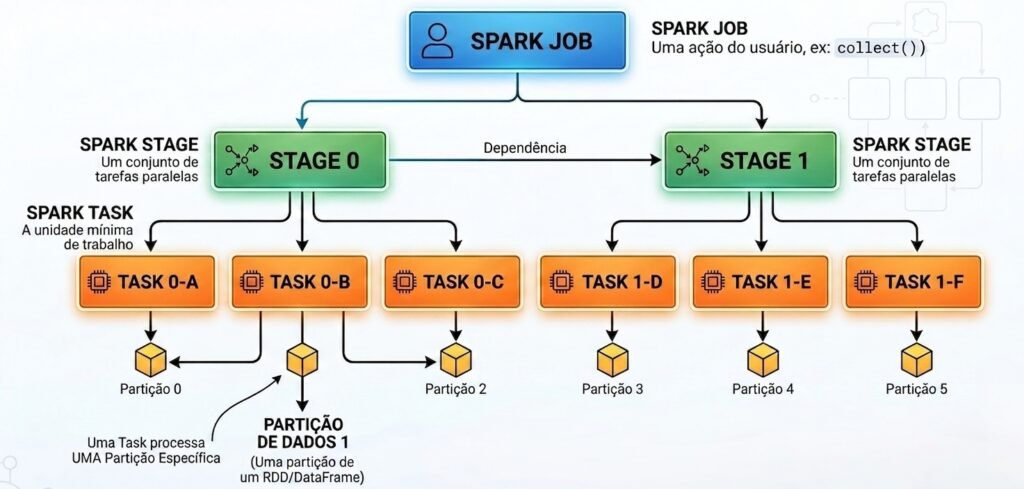
Essa divisão em novos stages existe por causa de um processo chamado shuffle. Shuffle acontece quando os dados que precisam ficar juntos para um cálculo estão espalhados em partições diferentes, às vezes até em executores diferentes, e o Spark precisa movê-los pela rede para reorganizá-los antes de continuar. É o que ocorre, por exemplo, ao somar vendas por estado: se os pedidos de um mesmo estado estiverem distribuídos em várias partições, o Spark primeiro precisa reunir todos esses registros nas mesmas partições antes de somar os valores. Esse deslocamento de dados entre máquinas é uma das operações mais custosas do Spark, porque depende de rede e de gravação temporária em disco, ao contrário do restante do processamento, que roda majoritariamente em memória. Por isso, reduzir a quantidade de shuffles é uma das formas mais eficazes de deixar um processamento em Spark mais rápido.
Essa combinação de dividir dados em partições, processar em paralelo em várias máquinas e juntar os resultados no final é o que dá ao Spark sua velocidade e capacidade de lidar com volumes de dados que não caberiam em um computador só.
Arquitetura
Reunindo as peças descritas acima, a arquitetura do Spark segue um modelo de mestre e trabalhadores. O driver atua como o mestre: coordena tudo, mantém o controle do que já foi feito e do que falta fazer. Os executores são os trabalhadores: recebem tarefas, processam os dados e devolvem resultados. E o gerenciador de cluster é o intermediário que aloca máquinas para que esse trabalho aconteça.
Por cima dessa estrutura de execução, o Spark oferece módulos especializados para diferentes tipos de tarefas. O Spark SQL permite consultar e transformar dados usando SQL e APIs estruturadas, de forma semelhante ao trabalho realizado em bancos de dados. O Structured Streaming permite processar dados que chegam continuamente, como eventos de aplicações, transações ou informações de sensores, sem precisar esperar que todos os dados sejam armazenados para então processá-los. Para machine learning, o Spark possui a MLlib, que reúne algoritmos e ferramentas para treinar modelos sobre grandes volumes de dados. Já o GraphX é voltado ao processamento de grafos, permitindo trabalhar com relacionamentos e conexões entre elementos, como pessoas em uma rede social ou contas em uma rede financeira.
Onde ele roda e como um cluster é organizado
O Spark não depende de um tipo específico de infraestrutura, mas para entender de verdade onde ele roda, vale abrir um pouco mais o que é esse “cluster” mencionado o tempo todo.
Um cluster nada mais é do que um conjunto de computadores conectados em rede, trabalhando juntos como se fossem um único sistema. Dentro desse conjunto, as máquinas assumem papéis diferentes. Uma ou mais máquinas ficam responsáveis por coordenar o trabalho — é ali que roda o driver e, dependendo da configuração, também o gerenciador de cluster. As demais máquinas são os chamados nós de trabalho (worker nodes), que é onde os executores efetivamente rodam e processam os dados. Cada nó de trabalho normalmente contribui com uma fatia da sua CPU e da sua memória RAM para o processamento, e quanto mais nós disponíveis, mais tarefas podem rodar ao mesmo tempo.
Em um ambiente on-premises — ou seja, quando a própria empresa é dona e mantém fisicamente os servidores, geralmente em um data center próprio — alguém da equipe de infraestrutura precisa instalar o Spark manualmente em cada máquina do cluster, configurar a rede entre elas e decidir qual gerenciador de cluster será usado para organizar o trabalho: pode ser o gerenciador nativo do próprio Spark (chamado de modo Standalone), ou ferramentas mais robustas como YARN ou Kubernetes. Isso costuma envolver instalar o Java (já que o Spark roda sobre a máquina virtual do Java), baixar os arquivos do Spark, definir qual máquina será o “mestre” e quais serão os “trabalhadores”, e configurar essa comunicação entre elas.
Na nuvem, esse processo manual praticamente desaparece. Serviços como Databricks, Amazon EMR, Google Dataproc e Azure Synapse já entregam o Spark pré-instalado e pré-configurado. Basta a empresa escolher quantas máquinas quer usar e por quanto tempo, e o próprio serviço cuida de ligar essas máquinas, instalar o Spark nelas, organizar quem é o driver e quem são os executores, e depois desligar tudo automaticamente quando o processamento termina. É por isso que a nuvem se tornou o caminho mais comum atualmente: reduz drasticamente o trabalho de configuração e permite aumentar ou diminuir o tamanho do cluster conforme a necessidade, pagando apenas pelo tempo em que as máquinas ficaram ligadas.
Em ambos os casos, o resultado final é parecido: um conjunto de máquinas conectadas, com uma organizando o trabalho e as outras executando esse trabalho em paralelo — só muda quem é responsável por montar e manter essa estrutura.
Rodando o PySpark localmente, sem cluster
Uma dúvida comum é o que acontece quando alguém instala o PySpark no próprio notebook ou computador pessoal, sem nenhum cluster por trás. Nesse cenário, o Spark entra no chamado modo local: em vez de distribuir o trabalho entre várias máquinas, ele simula um cluster inteiro dentro da própria máquina, usando os núcleos do processador como se fossem “executores”.
Isso significa que sim, o Spark aproveita múltiplos núcleos da CPU mesmo rodando localmente, desde que configurado para isso. Ao iniciar uma sessão do PySpark, é possível informar quantos núcleos devem ser usados, por exemplo:
from pyspark.sql import SparkSession
# "local[*]" instrui o Spark a usar todos os núcleos disponíveis na máquina
spark = SparkSession.builder \
   .appName("ExemploLocal") \
   .master("local[*]") \
   .getOrCreate()
O local[*] diz ao Spark para usar todos os núcleos disponíveis no processador. Também é possível especificar um número fixo, como local[4], para usar exatamente quatro núcleos, ou local[1], que roda tudo em um único núcleo, sem paralelismo algum — útil apenas para testes bem simples. Sem essa configuração, ou se ela não for definida corretamente, o Spark pode acabar usando só um núcleo, perdendo boa parte do ganho de desempenho que o motivaria a ser usado.
Vale reforçar que o modo local não tem o benefício de escalar além dos recursos de uma única máquina: se o processamento exigir mais memória ou mais poder de processamento do que aquele computador tem disponível, ele vai travar ou ficar extremamente lento, independente de quantos núcleos estejam configurados. O modo local é ótimo para aprender, testar e desenvolver código antes de rodá-lo de verdade em um cluster com várias máquinas, mas não substitui um cluster quando o volume de dados realmente cresce.
Ainda é muito usado?
Sim, e de forma expressiva. Mesmo tendo mais de quinze anos, o Spark continua entre os motores de processamento de dados mais adotados no mercado corporativo, principalmente em cenários de processamento de dados em tempo real (streaming), onde é usado por milhares de empresas ao redor do mundo. Setores como serviços financeiros, saúde, telecomunicações e varejo mantêm forte presença de Spark em suas operações, e ele segue como peça central da própria Databricks, empresa fundada por seus criadores originais.
Concorrentes
Existem algumas alternativas que competem com o Spark em diferentes frentes. O Apache Flink é focado especificamente em processamento de dados em tempo real com respostas muito rápidas, e em cenários que exigem essa velocidade extrema costuma superar o Spark tecnicamente. O próprio Hadoop MapReduce, antecessor do Spark, ainda aparece em sistemas mais antigos, embora tenha caído bastante em popularidade. Serviços como Amazon Redshift, Google BigQuery e Snowflake competem em cenários de consulta e análise de dados prontos para uso, funcionando mais como bancos de dados analíticos gerenciados do que como motores de processamento flexíveis. Já ferramentas como Dask e Ray vêm ganhando espaço especialmente entre quem trabalha com Python e ciência de dados, oferecendo alternativas mais leves para tarefas específicas.
O que mantém o Spark relevante em meio a tanta concorrência é justamente sua versatilidade: ele cobre processamento em lote, tempo real (streaming de dados), consultas parecidas com SQL, machine learning e análise de redes dentro de uma única plataforma, enquanto boa parte das alternativas foca em resolver bem apenas um desses problemas.
Linguagens necessárias
O próprio Spark foi escrito na linguagem Scala e roda sobre a máquina virtual do Java, a mesma tecnologia por trás de programas Java. Mas isso não significa que seja preciso aprender Scala para usá-lo. O Spark oferece formas de ser utilizado em várias linguagens diferentes, e a mais popular hoje em dia é o Python, através de uma extensão chamada PySpark, muito usada entre profissionais de dados e machine learning por já ser uma linguagem familiar para essa comunidade. Também é possível usar Java, e R, essa última mais comum em contextos de estatística. Para quem só precisa consultar e filtrar dados, sem necessariamente programar, existe ainda a opção de usar apenas comandos parecidos com SQL. Na prática, boa parte de quem começa a trabalhar com Spark hoje entra por meio do Python, sem nunca precisar tocar em Scala.
Exemplo prático de aplicação
Para tornar tudo isso mais concreto, imagine uma empresa de e-commerce que recebe milhões de pedidos por dia e quer descobrir, ao final de cada dia, quais produtos foram mais vendidos em cada estado do país. Sem o Spark, alguém precisaria carregar um arquivo gigante com todos os pedidos do dia em um único computador, o que poderia levar horas ou nem ser possível, dependendo do tamanho do arquivo e da memória disponível.
Com o Spark, esse arquivo de pedidos é dividido em partições e distribuído entre as máquinas de um cluster. Cada máquina processa sua parte, somando as vendas de cada produto dentro do recorte de dados que recebeu. O Spark então junta esses resultados parciais entre si, cruzando as somas de diferentes máquinas até chegar ao total certo por produto e por estado. O resultado final — algo como uma tabela com os produtos mais vendidos por região — é entregue de volta rapidamente, mesmo tendo processado milhões de linhas de dados, porque o trabalho pesado foi dividido e feito em paralelo. Esse mesmo tipo de fluxo se repete em cenários como detecção de fraude em cartões de crédito, recomendação de conteúdo em plataformas de streaming e análise de sensores em fábricas.
Para ilustrar como isso aparece no código, veja um exemplo simplificado em PySpark que faz exatamente esse cálculo de total vendido por estado:
from pyspark.sql import SparkSession
from pyspark.sql.functions import sum as spark_sum

spark = SparkSession.builder.appName("VendasPorEstado").getOrCreate()

# Lê o arquivo de pedidos, que o Spark automaticamente divide em partições
pedidos = spark.read.csv("pedidos.csv", header = True, inferSchema = True)

# Mostra em quantas partições o arquivo foi dividido
print("Número de partições:", pedidos.rdd.getNumPartitions())

# Agrupa por estado e soma o valor total de vendas — isso é uma transformação,
# ainda não foi executado de verdade
vendas_por_estado = pedidos.groupBy("estado").agg(spark_sum("valor_total").alias("total_vendido"))

# Só quando pedimos para exibir ou salvar o resultado é que o processamento
# realmente acontece, distribuído entre as partições — isso é uma ação vendas_por_estado.orderBy("total_vendido", ascending = False).show()
Nesse código, a linha que lê o arquivo CSV já divide automaticamente os dados em partições, cujo número pode ser consultado com getNumPartitions(). A operação groupBy seguida de agg é uma transformação: o Spark só anota que precisa agrupar por estado e somar os valores, sem executar nada ainda. É apenas na linha final, com o show(), que o Spark de fato dispara o processamento — e é nesse momento que o Spark cria as tarefas necessárias para processar as partições e as distribui entre os executors disponíveis (ou entre os núcleos disponíveis, no caso do modo local), cada um calculando a soma da sua fatia de dados, até os resultados parciais serem combinados no total final por estado.
Conclusão
O Apache Spark resolve um problema bem concreto: processar volumes de dados grandes demais para uma única máquina, de forma rápida e confiável, dividindo o trabalho entre várias máquinas e aproveitando ao máximo a memória disponível em vez de depender constantemente do disco. Nasceu como resposta às limitações do Hadoop MapReduce, mas cresceu para se tornar uma plataforma completa, capaz de lidar com consultas, dados em tempo real, machine learning e análise de redes dentro de um único ecossistema. Mesmo com a chegada de concorrentes especializados em nichos específicos, sua versatilidade e a maturidade de mais de uma década de desenvolvimento mantêm o Spark como uma das ferramentas mais relevantes no mundo do processamento de grandes volumes de dados, sendo hoje acessível até para quem só conhece Python, sem exigir conhecimento prévio de Scala ou de sistemas distribuídos complexos.
Comentários (0)
Seja o primeiro a comentar.