MLOps: a ponte entre Ciência de Dados e Produção
 Rael Rodrigues
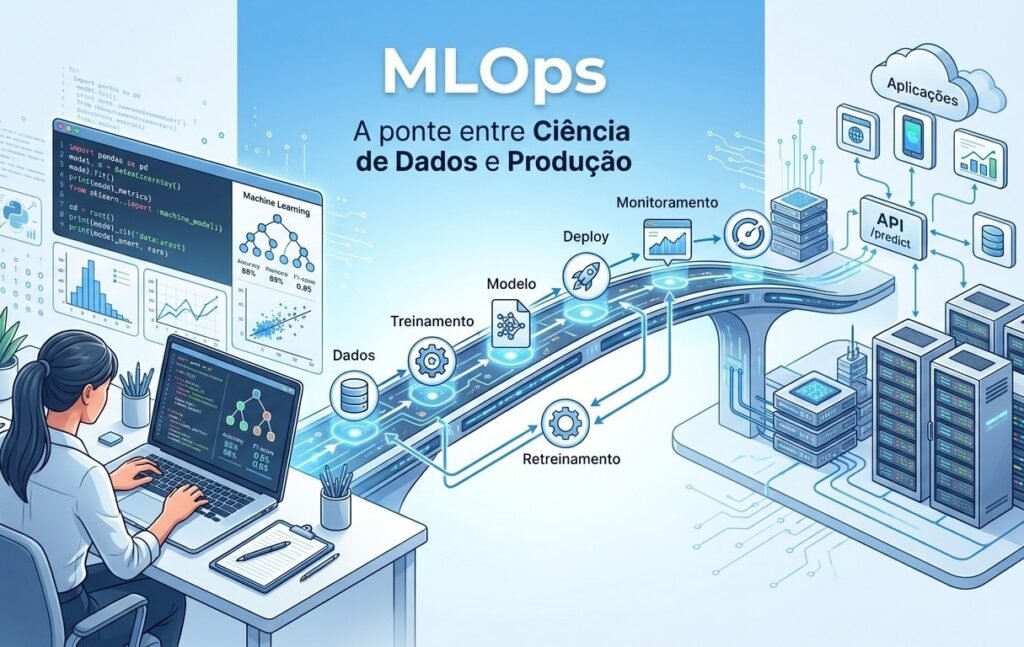
Nos últimos anos, empresas de todos os tamanhos passaram a investir pesado em Inteligência Artificial e Machine Learning. Mas um problema recorrente surgiu: modelos que funcionavam muito bem em notebooks de experimentação simplesmente não sobreviviam ao mundo real. Eles quebravam em produção, ficavam desatualizados, eram impossíveis de monitorar ou, pior, ninguém sabia mais explicar como haviam sido treinados.
É nesse contexto que nasce o MLOps (Machine Learning Operations): um conjunto de práticas, cultura e ferramentas que aplica princípios de engenharia de software e operações (DevOps) ao ciclo de vida completo de modelos de Machine Learning.
De onde surgiu o MLOps e por quê
O termo MLOps é uma extensão direta do conceito de DevOps, popularizado no fim dos anos 2000, que uniu desenvolvimento (Dev) e operações (Ops) para acelerar entregas de software com mais qualidade e confiabilidade, por meio de integração contínua, automação e colaboração entre times.
Só que Machine Learning tem uma complexidade que o software tradicional não tem: além do código, existe o modelo e, principalmente, os dados. Um sistema de ML pode falhar não porque o código mudou, mas porque a distribuição dos dados de entrada mudou (o chamado data drift), ou porque o comportamento que o modelo deveria prever mudou ao longo do tempo (concept drift).
Por volta de 2015, à medida que empresas como Google, Uber, Netflix e Airbnb começaram a colocar centenas de modelos em produção, ficou evidente que faltavam práticas maduras para:
- Versionar dados e modelos, não só código;
- Reproduzir experimentos de forma confiável;
- Automatizar re-treinamento quando o modelo perdia performance;
- Monitorar modelos em produção como se monitora qualquer outro serviço crítico;
- Garantir governança, rastreabilidade e conformidade regulatória.
Esse conjunto de desafios, específico do ciclo de vida de Machine Learning, contribuiu para o surgimento e a consolidação das práticas que hoje conhecemos como MLOps. Publicações como o artigo “Hidden Technical Debt in Machine Learning Systems”, do Google, publicado em 2015, ajudaram a evidenciar a complexidade operacional dos sistemas de Machine Learning e a necessidade de práticas específicas para gerenciar seu ciclo de vida. Com o crescimento da adoção de Machine Learning em ambientes de produção, essas práticas foram sendo consolidadas e acompanhadas pelo surgimento de ferramentas dedicadas.
Por que o MLOps é importante
Sem MLOps, projetos de Machine Learning tendem a sofrer de problemas bem conhecidos. Um deles é a síndrome do “funciona na minha máquina”, em que modelos treinados localmente simplesmente não reproduzem o mesmo comportamento em produção. Outro é o surgimento de modelos “zumbis”: sistemas em produção que ninguém mais sabe explicar ou re-treinar, muitas vezes porque a pessoa que os criou já não está mais na equipe ou porque o processo nunca foi documentado. Também é comum a falta de monitoramento, que permite que a performance de um modelo se degrade silenciosamente ao longo do tempo sem que ninguém perceba, até que o impacto no negócio já seja significativo. Some-se a isso ciclos lentos, em que meses se passam entre a ideia de um modelo e seu uso real por clientes, e a falta de governança, que dificulta auditar decisões automatizadas — algo cada vez mais exigido por regulações como a LGPD e o AI Act europeu.
O MLOps ataca diretamente esses problemas. Ele traz velocidade, por meio de ciclos de treinamento, validação e deploy automatizados; confiabilidade, com testes, versionamento e rollback tratados como em qualquer sistema de software crítico; e escalabilidade, permitindo gerenciar dezenas ou até centenas de modelos simultaneamente sem que isso vire um processo caótico. Também promove colaboração, aproximando cientistas de dados, engenheiros de ML, engenheiros de dados e times de infraestrutura, que passam a falar a mesma língua ao longo de todo o ciclo de vida do modelo. E, por fim, garante governança, oferecendo rastreabilidade completa sobre qual dado, qual código e qual versão de modelo gerou determinada decisão.
Conceitos fundamentais de MLOps
1. Versionamento
Assim como usamos o Git para versionar código, também precisamos versionar os dados e os modelos treinados. Isso garante que qualquer experimento possa ser refeito exatamente do mesmo jeito no futuro.
2. Reprodutibilidade
Usando o mesmo código, os mesmos dados, as mesmas configurações e um ambiente controlado, deve ser possível reproduzir um experimento e obter resultados equivalentes ou muito próximos. Parece simples, mas sem as ferramentas certas é bem difícil de garantir.
3. CI/CD/CT (Integração, Entrega e Treinamento Contínuos)
O MLOps pega emprestado o CI/CD do mundo do desenvolvimento de software e adiciona um novo conceito: o Treinamento Contínuo (CT). São pipelines capazes de re-treinar automaticamente o modelo em intervalos definidos ou quando determinados gatilhos são acionados, como a chegada de novos dados, mudanças na distribuição dos dados ou degradação da performance.
4. Feature Store
É um repositório central onde ficam guardadas as variáveis (features) usadas pelos modelos. Isso ajuda a evitar o training-serving skew, situação em que uma feature é calculada de uma maneira durante o treinamento e de outra maneira quando o modelo está em produção.
5. Monitoramento de Modelos
É acompanhar continuamente como o modelo está se saindo: sua performance (acurácia, velocidade de resposta) e a qualidade dos dados que ele recebe, com alertas automáticos quando algo foge do esperado.
6. Model Registry
Repositório centralizado para registrar modelos, suas versões, métricas, metadados e status de implantação.
7. Governança
Conjunto de políticas e processos que garantem rastreabilidade, segurança, controle de acesso, auditoria e conformidade ao longo do ciclo de vida dos modelos.
8. Experiment Tracking
É o registro organizado de todos os experimentos feitos — o que foi testado, quais resultados deu — para facilitar a comparação e a escolha do melhor modelo.
Ferramentas do ecossistema MLOps
O ecossistema de ferramentas de MLOps é grande, mas dá para pensar nele de um jeito simples: existe uma ferramenta para (quase) cada etapa do ciclo de vida do modelo.
| Categoria | Ferramentas mais usadas |
| Versionamento de dados/modelos | DVC, Git LFS, LakeFS |
| Experiment tracking | MLflow, Weights & Biases (W&B), Neptune.ai, Comet |
| Orquestração de pipelines | Apache Airflow, Kubeflow Pipelines, Prefect, Dagster |
| Feature Store | Feast, Tecton, Databricks Feature Store |
| Treinamento e serving em escala | Kubeflow, Ray, SageMaker, Vertex AI, Azure ML |
| Empacotamento e deploy | Docker, MLflow Models, BentoML, TorchServe, TensorFlow Serving |
| Monitoramento em produção | Evidently AI, WhyLabs, Arize AI, Fiddler |
| Model Registry | MLflow Model Registry, SageMaker Model Registry, Vertex AI Model Registry |
| Infraestrutura como código | Terraform, Kubernetes, Helm |
Duas ferramentas que merecem destaque especial no ecossistema open source são MLflow e Kubeflow.
O MLflow funciona como um “caderno de anotações” para experimentos: cada vez que um modelo é treinado, ele registra automaticamente os parâmetros usados, os resultados obtidos e os arquivos gerados. Também conta com um Model Registry, um catálogo onde ficam guardadas as versões aprovadas dos modelos. É leve, fácil de começar a usar e não exige uma infraestrutura complexa.
Já o Kubeflow tem outro foco: ele roda pipelines de Machine Learning completos dentro do Kubernetes, permitindo automatizar desde o preparo dos dados até o treinamento e o deploy, em escala. É uma solução mais robusta, indicada para quando o volume de modelos e dados já é grande.
Na prática, as duas costumam trabalhar juntas: o Kubeflow cuida da orquestração e execução em escala, enquanto o MLflow cuida do rastreamento dos experimentos e do registro dos modelos.
O Pipeline de MLOps
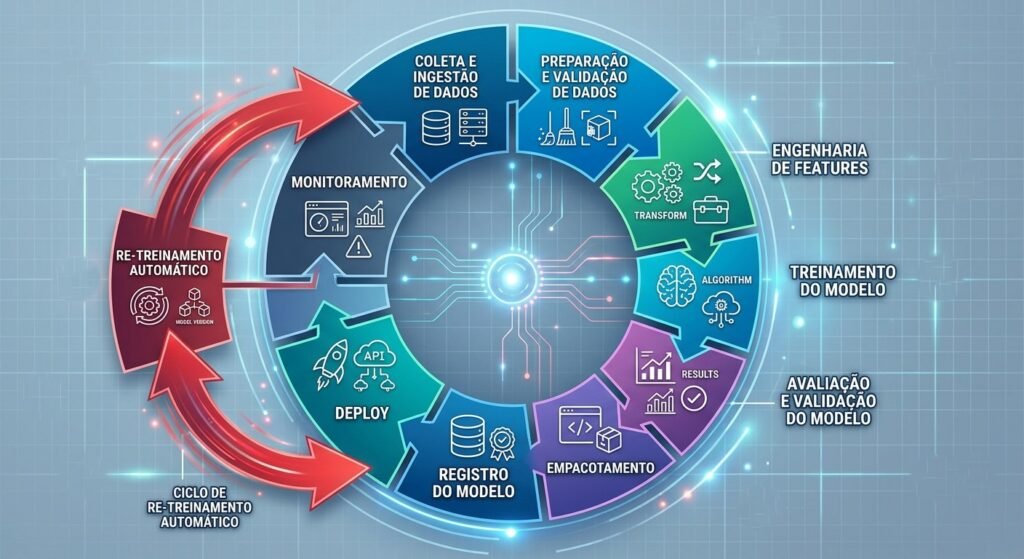
Um pipeline de MLOps típico é dividido em estágios encadeados e, idealmente, automatizados:
- Coleta e Ingestão de Dados — dados são extraídos de fontes (bancos, APIs, streaming) e armazenados em um data lake ou warehouse.
- Preparação e Validação de Dados — limpeza, tratamento de valores ausentes, checagem de qualidade e schema dos dados.
- Engenharia de Features — criação e armazenamento de variáveis preditivas, idealmente em uma Feature Store.
- Treinamento do Modelo — experimentação, ajuste de hiperparâmetros e treinamento propriamente dito, com todo experimento sendo registrado (experiment tracking).
- Avaliação e Validação do Modelo — comparação com modelos anteriores (baseline), testes de métricas de negócio e de viés/fairness.
- Empacotamento (Packaging) — o modelo é serializado e empacotado, geralmente em um container Docker, junto com suas dependências.
- Registro do Modelo (Model Registry) — versão aprovada é registrada com metadados completos.
- Deploy / Serving — o modelo é disponibilizado como uma API (serving em tempo real) ou como um job em lote (batch scoring).
- Monitoramento — acompanhamento contínuo de performance, drift e saúde do sistema.
- Re-treinamento (Continuous Training) — quando gatilhos de degradação são disparados, o pipeline reinicia automaticamente a partir da etapa 1 ou 3.
Esse fluxo é frequentemente representado como um ciclo contínuo (e não linear), pois o modelo em produção realimenta constantemente o processo de melhoria.
Onde o MLOps roda
Um pipeline de MLOps pode rodar em diferentes ambientes, a depender da maturidade e necessidade da empresa:
- Cloud pública (nuvem gerenciada): as três grandes provedoras oferecem plataformas completas de MLOps — Amazon SageMaker (AWS), Vertex AI (Google Cloud) e Azure Machine Learning (Microsoft Azure). Essas plataformas cobrem praticamente todo o ciclo, do treinamento ao monitoramento.
- Kubernetes (on-premise ou cloud): muitas empresas optam por construir seu próprio stack sobre Kubernetes, usando ferramentas open-source como Kubeflow, MLflow e Airflow, ganhando portabilidade e evitando vendor lock-in (situação onde o cliente fica preso a um fornecedor específico).
- Ambientes híbridos: combinação de infraestrutura própria (on-premise, por questões de custo ou compliance) com serviços de nuvem para picos de processamento (treinamento pesado com GPUs, por exemplo).
- Edge Computing: em casos como IoT, carros autônomos ou dispositivos móveis, o modelo treinado na nuvem é implantado diretamente no dispositivo (edge), exigindo pipelines específicos de otimização e empacotamento (ex.: TensorFlow Lite, ONNX Runtime).
A escolha do ambiente depende de fatores como volume de dados, exigências de latência, orçamento, requisitos de compliance (dados sensíveis que não podem sair do país, por exemplo) e a maturidade da equipe em gerenciar infraestrutura própria.
Um exemplo prático: previsão de inadimplência
Para tornar tudo isso mais concreto, imagine um banco que quer prever a probabilidade de um cliente se tornar inadimplente antes de aprovar um novo empréstimo. Sem MLOps, essa história costuma se repetir: um cientista de dados desenvolve um modelo em seu notebook, obtém bons resultados, envia o arquivo do modelo por e-mail para o time de tecnologia, e meses depois ninguém mais lembra exatamente como aquele modelo foi treinado nem consegue atualizá-lo. Com MLOps, o mesmo projeto ganha um fluxo bem diferente.
Tudo começa com a ingestão de dados históricos de clientes: renda, histórico de pagamentos, score de crédito, tempo de relacionamento com o banco, entre outras variáveis, extraídas automaticamente dos sistemas internos. Essas variáveis são calculadas e organizadas em uma Feature Store, garantindo que, quando o modelo for usado para avaliar um novo pedido de empréstimo em produção, ele use exatamente o mesmo cálculo de “tempo de relacionamento” ou “renda comprometida” usado durante o treinamento.
O time de dados treina então diferentes versões do modelo — testando algoritmos, ajustando parâmetros — e cada tentativa fica automaticamente registrada por uma ferramenta de experiment tracking, como o MLflow. Isso permite comparar facilmente qual versão teve a melhor performance, sem depender da memória de quem fez o experimento. A versão vencedora passa por uma etapa de validação, em que não só a acurácia é avaliada, mas também se o modelo não está discriminando indevidamente algum grupo de clientes (viés), algo especialmente sensível em decisões de crédito.
Aprovado, o modelo é empacotado em um container e registrado em um Model Registry, junto com todas as informações de quem o treinou, com quais dados e em qual data. Só então ele é implantado como uma API: toda vez que uma nova solicitação de empréstimo chega, o sistema consulta essa API, que retorna a probabilidade de inadimplência em milissegundos, fornecendo uma estimativa de risco que pode ser utilizada como um dos elementos de apoio à decisão de crédito.
A partir daí, o trabalho não termina — pelo contrário, começa o monitoramento contínuo. Ferramentas de observabilidade acompanham se o perfil dos clientes que estão pedindo empréstimo está mudando (por exemplo, em um cenário de crise econômica) e se a taxa de acerto do modelo está caindo. Se um gatilho de degradação ou mudança significativa nos dados for disparado, o pipeline de re-treinamento entra em ação automaticamente, gerando uma nova versão do modelo, testando-a e, se aprovada, substituindo a versão anterior em produção — tudo isso com rastreabilidade completa, permitindo que, se algum dia um auditor perguntar por que um cliente específico teve seu crédito negado, o banco consiga explicar exatamente qual modelo, treinado com quais dados, tomou aquela decisão.
Conclusão
MLOps não é apenas uma tendência passageira ou um conjunto de ferramentas da moda — é a resposta natural e necessária ao amadurecimento da Inteligência Artificial dentro das empresas. Assim como o DevOps foi essencial para que o desenvolvimento de software se tornasse ágil, confiável e escalável, o MLOps é um dos principais fatores que permitem transformar experimentos de Machine Learning em soluções confiáveis, escaláveis e sustentáveis em produção.
Investir em MLOps significa investir em processos, cultura de colaboração entre times e nas ferramentas certas — para que a Inteligência Artificial deixe de ser um projeto pontual e passe a ser um sistema vivo, confiável e evolutivo dentro da organização.
Comentários (0)
Seja o primeiro a comentar.